

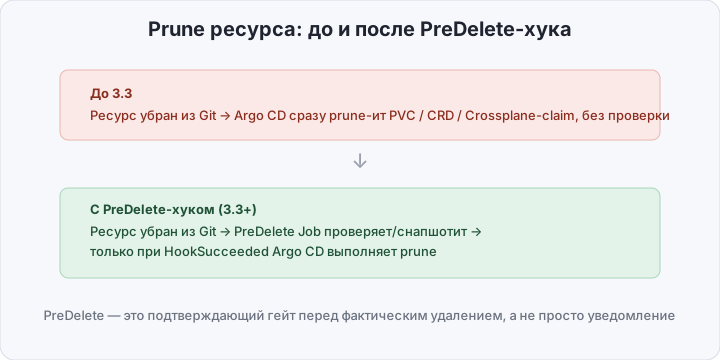
До Argo CD 3.3 удаление ресурса в GitOps было устроено до обидного просто: убираете строчку из манифеста, синк детектирует «этого больше нет в Git» и сразу prune-ит объект — без разницы, обычный это ConfigMap или StatefulSet со стейтом, который стоило бы сперва забэкапить. 3.3 добавляет PreDelete-хуки — новую стадию lifecycle, которая наконец даёт GitOps тот самый «вы уверены?», который человек обычно делает руками перед kubectl delete. Разбираемся, как это работает и что сделать, чтобы стейтфул-нагрузки перестали быть в шаге от случайного prune.
Содержание
Открыть содержание
Как раньше вело себя prune
Sync в Argo CD всегда работал по одной и той же логике: сравнить желаемое состояние (то, что в Git) с фактическим состоянием кластера и привести второе к первому. Если ресурс присутствует в кластере, но отсутствует в Git, и включён prune (автоматически через automated.prune: true или вручную флагом --prune), Argo CD его удаляет. Никакой промежуточной проверки между «ресурса больше нет в манифесте» и «ресурс удалён из кластера» не было — только PreSync/Sync/PostSync/SyncFail, ни один из которых не относится к удалению.
На практике это провоцировало вполне конкретные инциденты:
- Потеря PVC. Если
PersistentVolumeClaimописан в манифестах явно (а не только черезvolumeClaimTemplatesStatefulSet), удаление или переименование ресурса в Git тут же triggers prune самого PVC — вместе с данными, которые физически связаны сPersistentVolume, еслиreclaimPolicyнеRetain. - Осиротевшие или подвисшие CRD с финализаторами. Убрать из Git кастомный ресурс, у которого есть финализатор, — значит запустить Kubernetes-уровневый цикл удаления без предупреждения: либо объект зависает в
Terminatingнавсегда, если контроллер, отвечающий за финализатор, недоступен, либо, наоборот, контроллер успевает довести очистку до конца раньше, чем кто-либо заметил, что удаление вообще произошло. - Облачные ресурсы через Crossplane. Prune
Claim/Composite-ресурса Crossplane — это не «убрать объект из etcd», это запуск реального удаления managed-ресурса в облаке: RDS-инстанс, S3-бакет, VPC. Один неудачный merge конфликта, который случайно убрал блок YAML с этимClaim, — и следующий автосинк удаляет продовую базу без единого предупреждения.
Общее во всех трёх случаях: у sync не было понятия «подтверди перед тем, как удалять» — только бинарное «в Git есть / в Git нет». Релиз 3.3 вышел в цикле февраль–март 2026, и deletion safety названа самым заметным изменением релиза — не новая интеграция или UI-фича, а закрытие именно этой дыры.
PreDelete: новая стадия lifecycle
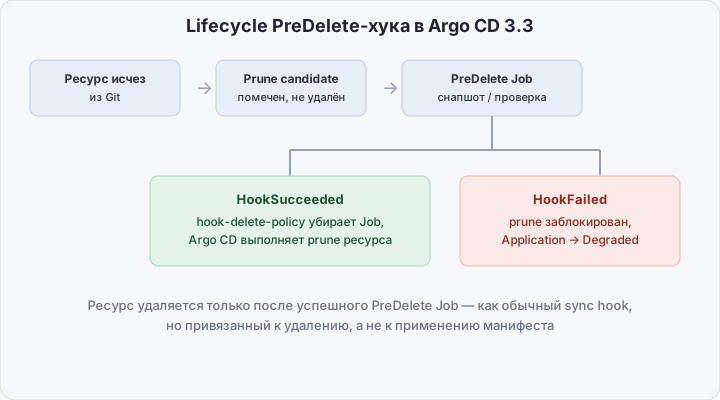
У Argo CD и раньше были sync hooks — PreSync, Sync, PostSync, SyncFail — обычные Kubernetes-манифесты (чаще всего Job), помеченные аннотацией argocd.argoproj.io/hook, которые контроллер применяет и ждёт в соответствующей точке синка. PreDelete устроен по тому же принципу, но привязан не к применению манифеста, а к удалению: хук запускается после того, как ресурс помечен prune candidate, и до того, как Argo CD фактически его удаляет.
apiVersion: batch/v1
kind: Job
metadata:
  name: predelete-check
  annotations:
    argocd.argoproj.io/hook: PreDelete
    argocd.argoproj.io/hook-delete-policy: HookSucceeded
Семантика hook-delete-policy для PreDelete та же, что и для остальных хуков, но с другим следствием:
HookSucceeded— Job самого хука удаляется после успешного завершения, а prune целевого ресурса выполняется.HookFailed— если хук завершился ошибкой, Job хука остаётся в кластере для диагностики, а prune целевого ресурса не происходит: Argo CD помечаетApplicationкакDegradedи ждёт вмешательства.BeforeHookCreation— если предыдущий запуск хука ещё висит в кластере (например, после ручного ретрая), старый Job удаляется перед созданием нового.
Ключевое отличие от PreSync/PostSync: там неудача хука блокирует применение манифестов, здесь — блокирует конкретно удаление. Всё остальное состояние Application продолжает синкаться как обычно, заблокирован только prune ресурса, за который отвечает упавший PreDelete-хук.
Комбинация с финализаторами и Prune=false
PreDelete-хук не заменяет ни Kubernetes-финализаторы, ни sync-option Prune=false — это три механизма с разной зоной ответственности, и для стейтфул-ресурсов их стоит сочетать, а не выбирать один вместо другого.
Финализатор — гарантия на уровне Kubernetes: он сработает независимо от того, кто инициировал удаление — Argo CD prune, kubectl delete в обход GitOps или чей-то скрипт. PreDelete-хук видит только удаления, которые проходят через сам Argo CD sync; ручной kubectl delete его полностью обходит. Поэтому для ресурсов, где важна гарантия «это никогда не удалится без ручного подтверждения», надёжнее не полагаться только на хук, а держать sync-option Prune=false прямо на ресурсе — Argo CD в принципе никогда не тронет его автоматически, удаление остаётся полностью ручной операцией:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pgdata-postgres-0
  annotations:
    argocd.argoproj.io/sync-options: Prune=false
PreDelete в этой схеме — не замена жёсткому стопу, а гейт для ресурсов, которые вы хотите оставить pruneable, но с обязательной проверкой перед этим: типичный кандидат — Claim Crossplane, который в принципе должен удаляться вместе с окружением, но перед этим стоит снять финальный снапшот или подтвердить, что бэкап свежий.
Что происходит со старыми Application без миграции
Изменение полностью обратно совместимо: PreDelete — это opt-in. Если в манифестах Application нет ни одного ресурса с аннотацией argocd.argoproj.io/hook: PreDelete, поведение prune не меняется вообще — синк по-прежнему удаляет ресурсы, отсутствующие в Git, сразу же, как и до 3.3. Никакого автоматического включения гейта задним числом не происходит: команды, которые уже полагаются на текущее поведение prune (например, в CI, который пересоздаёт ephemeral-окружения), не увидят разницы, пока сами не добавят хук.
Практический вывод отсюда простой: миграция — это не «обновить Argo CD и подождать», а конкретная задача — пройтись по Application со стейтфул-ресурсами (PVC, CRD с финализаторами, Crossplane claims) и добавить им либо PreDelete-хук, либо Prune=false, там где логика важнее автоматизации.
Кратко: hydration стал быстрее
В этом же релизе Argo CD подтянул производительность hydration — генерации итоговых манифестов из Git-источника перед sync — за счёт более агрессивного кэширования промежуточных результатов рендера для больших монорепозиториев с десятками Application на одном источнике. К deletion safety это отношения не имеет, но для команд с крупными GitOps-монорепо это заметное сокращение времени до следующего sync — можно считать бонусом того же релизного цикла.
Что нужно, чтобы защитить StatefulSet+PVC
Возьмём типичный случай: StatefulSet с Postgres и явно объявленным PersistentVolumeClaim, который нужно не терять молча при случайном prune. Нужен CSI-драйвер с поддержкой VolumeSnapshot (VolumeSnapshotClass в кластере) и Argo CD 3.3+.
PreDelete-хук снимает снапшот PVC и ждёт, пока он станет readyToUse, прежде чем разрешить prune:
apiVersion: batch/v1
kind: Job
metadata:
  name: predelete-snapshot-pgdata
  annotations:
    argocd.argoproj.io/hook: PreDelete
    argocd.argoproj.io/hook-delete-policy: HookSucceeded
spec:
  template:
    spec:
      restartPolicy: Never
      serviceAccountName: predelete-snapshot
      containers:
        - name: snapshot
          image: bitnami/kubectl:1.31
          command:
            - /bin/sh
            - -c
            - |
              set -e
              SNAP_NAME="predelete-pgdata-postgres-0-$(date +%s)"
              kubectl apply -f - <<EOF
              apiVersion: snapshot.storage.k8s.io/v1
              kind: VolumeSnapshot
              metadata:
                name: ${SNAP_NAME}
                namespace: ${NAMESPACE}
              spec:
                volumeSnapshotClassName: csi-snapclass
                source:
                  persistentVolumeClaimName: pgdata-postgres-0
              EOF
              kubectl wait --for=jsonpath='{.status.readyToUse}'=true \
                volumesnapshot/${SNAP_NAME} --timeout=120s
Сам PVC при этом держим на жёстком стопе — снапшот не отменяет риск случайного удаления самого PVC тем же prune-циклом, если хук почему-то не сработает:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pgdata-postgres-0
  annotations:
    argocd.argoproj.io/sync-options: Prune=false
serviceAccountName: predelete-snapshot должен иметь RBAC на create/get для volumesnapshots.snapshot.storage.k8s.io в неймспейсе — без этого Job упадёт с Forbidden, и HookFailed заблокирует prune, что в данном случае и есть ожидаемое поведение по умолчанию: лучше заблокированный sync, чем потерянные данные.
Как проверить, что работает
Уберите StatefulSet из манифестов (или временно переименуйте) и запустите sync с prune:
argocd app sync my-app --pruneПока хук выполняется, Application покажет OutOfSync с прогрессом на PreDelete-хуке; логи снапшота смотрим напрямую:
kubectl logs job/predelete-snapshot-pgdata -n <namespace>Полезно один раз намеренно сломать хук (например, указать несуществующий volumeSnapshotClassName) и убедиться, что argocd app get my-app показывает Degraded, а сам PVC остаётся на месте — это подтверждение, что гейт реально блокирует удаление, а не просто существует в YAML.
Итог
Декларативному удалению в GitOps давно не хватало того же «вы уверены?», которое человек делает руками при kubectl delete — раньше единственным способом получить его было городить обёртки вокруг синка или полагаться на финализаторы, которые Argo CD prune всё равно обходит на своём уровне решения. PreDelete-хуки закрывают именно эту дыру: явный, видимый в UI гейт, который можно провалить и тем самым остановить удаление, а не просто залогировать его постфактум. Это не бесплатно — каждый хук нужно написать, дать ему RBAC и протестировать сценарий отказа, — но для команд со стейтфул-нагрузками в Argo CD это стоит внедрить до следующего prune, а не после инцидента с потерянным PVC.