

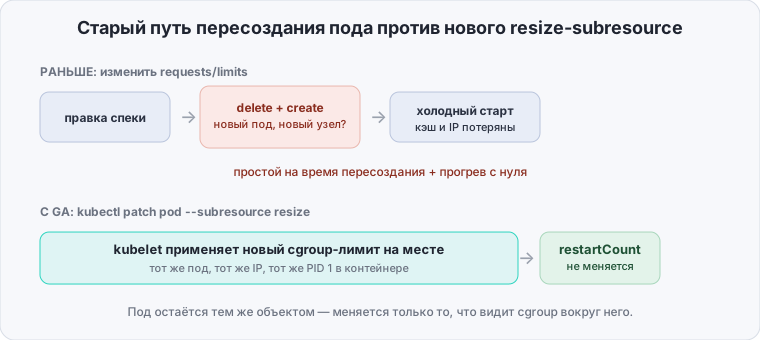
Раньше единственный способ поменять CPU или память у уже работающего пода — отредактировать requests/limits в спеке контроллера, дождаться, пока Kubernetes удалит старый под и создаст новый, и понадеяться, что он приземлится на тот же узел с той же локальностью данных. Kubernetes 1.35 закрывает эту главу: In-Place Pod Resize (KEP-1287) получил статус stable, и kubectl patch pod --subresource resize меняет ресурсы контейнера, пока он продолжает работать. Разбираем, что именно стало стабильным, что всё ещё форсирует рестарт, и как это стыкуется с VPA, scheduler и cluster-autoscaler.
Содержание
Открыть содержание
- Почему это раньше было больно
- Что именно стало stable в 1.35
- Что всё ещё форсирует рестарт контейнера
- Живой пример: resize запущенного пода
- Интеграция с Vertical Pod Autoscaler
- Что это меняет у scheduler и cluster-autoscaler
- Сравнение: было / стало
- Что нужно, чтобы включить это у себя
- Как проверить, что резайз действительно прошёл in-place
- Итог
Почему это раньше было больно
Под в Kubernetes — это не просто набор контейнеров, это ещё и requests/limits, зафиксированные в момент создания и намертво прибитые к объекту Pod. Поле spec.containers[].resources было неизменяемым: попытка поменять его через kubectl edit или kubectl apply отклонялась апи-сервером. Единственный легальный путь — пересоздать под целиком.
Для стейтлесс-сервиса за деплойментом это просто лишний rolling restart. Для всего остального — реальная цена:
- Stateful-под с локальным диском или długим прогревом кэша (базы данных, поисковые индексы, JVM с horizontal warm-up) теряет минуты или десятки минут на холодный старт после каждого пересоздания.
- Batch job с долгим единичным шагом, упёршимся в OOM, перезапускается с нуля вместо того, чтобы просто получить больше памяти на лету.
- VPA в режиме
Recreate— единственном рабочем режиме до этой фичи — по сути превращал вертикальное автомасштабирование в управляемый churn подов: помогает с профилем ресурсов, но платит за это доступностью и cold-start задержкой.
Kubernetes API это ограничение обходил кустарно: люди резервировали requests с запасом «на будущее», раздували лимиты «про запас» и мирились с тем, что VPA нельзя включить на что-то чувствительное к рестартам. In-place resize убирает саму причину компромисса — под остаётся тем же подом, с тем же IP, с тем же PID 1 в контейнере, просто с другим cgroup-лимитом вокруг него.
Что именно стало stable в 1.35
GA в 1.35 «Timbernetes» закрывает три вещи, которые раньше жили за feature gate InPlacePodVerticalScaling (alpha в 1.27, beta в 1.33):
- Подресурс
pods/resize. Отдельная RBAC-точка входа, через которую можно менятьresourcesконтейнера без полногоPATCHна сам под — то же разделение, что уже есть уpods/statusилиpods/exec. Значит, у CI-пайплайна или VPA-контроллера можно выдать право резайзить ресурсы, не давая права менять образ, команду или volumes. resizePolicyна уровне контейнера. Новое полеspec.containers[].resizePolicy, список изresourceName(cpuилиmemory) иrestartPolicyсо значениямиNotRequired(применить на лету) илиRestartContainer(пересоздать контейнер внутри того же пода, не трогая под целиком). Дефолт дляcpu— всегдаNotRequired: CPU-квота в cgroup — мягкое ограничение, ядро просто начинает больше или меньше планировать времени процессора, рестарт процессу для этого не нужен.- Статус фактически применённых ресурсов.
status.containerStatuses[].resourcesпоказывает, что реально действует в cgroup прямо сейчас, аstatus.containerStatuses[].allocatedResources— что учёл kubelet при подсчёте доступной ёмкости узла. Плюсstatus.conditionsс типамиPodResizePending/PodResizeInProgressи причинамиDeferred(не хватает места на узле прямо сейчас, ждём) илиInfeasible(никогда не влезет, например request больше allocatable узла).
Что всё ещё форсирует рестарт контейнера
In-place resize — это не «любое изменение ресурсов бесплатно». Рестарт контейнера (не пода целиком — под и его IP переживают этот рестарт) остаётся нужен в нескольких случаях:
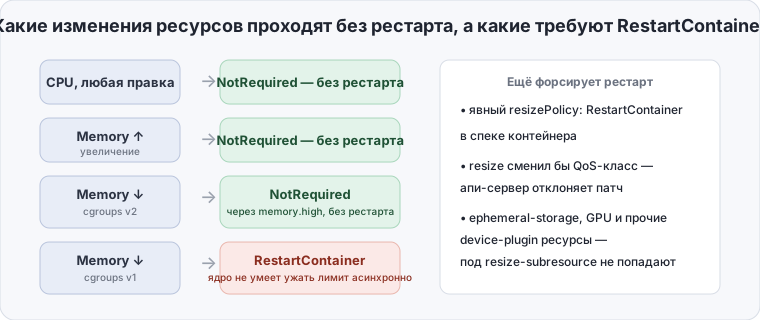
- Уменьшение memory limit на cgroups v1. cgroups v1 не умеет асинхронно ужать
memory.limit_in_bytesниже текущего потребления — ядро либо сразу зовёт OOM killer на разницу, либо операция просто не проходит. cgroups v2 сmemory.highкак мягким порогом решает это корректно: kubelet может снизить лимит, дать cgroup-у время сбросить страницы, и только потом закрепить жёсткийmemory.max. На v1 единственный безопасный путь уменьшить память —RestartContainer. - Явный
RestartContainerв policy для конкретного ресурса. Если вы сами прописалиresizePolicyсrestartPolicy: RestartContainerдляmemory(разумный дефолт для приложений, которые сами не освобождают память без рестарта процесса — например, у которых внутри собственный memory pool, растущий монотонно), kubelet рестартует контейнер при любом изменении этого ресурса, даже увеличении. - Изменение, которое поменяло бы QoS-класс пода. QoS (
Guaranteed/Burstable/BestEffort) вычисляется из соотношенияrequestsиlimitsна момент создания пода и после этого зафиксирован. Resize, который бы, например, превратилGuaranteedпод вBurstable(сделавrequests != limits), апи-сервер отклоняет ещё на входе — это не «требует рестарта», это вообще не проходит валидацию. - Ресурсы за пределами CPU/memory. Ephemeral-storage, extended resources, GPU и прочие device-plugin ресурсы под resize-subresource не попадают — как и раньше, единственный способ их поменять — пересоздание пода.
Живой пример: resize запущенного пода
Патчим память у контейнера, который уже работает, без единого рестарта — под cgroups v2 и resizePolicy: NotRequired:
kubectl get pod worker-0 -o jsonpath='{.status.containerStatuses[0].restartCount}{"\n"}'
# 0

kubectl patch pod worker-0 --subresource resize --patch \
  '{"spec":{"containers":[{"name":"worker","resources":{"requests":{"memory":"512Mi","cpu":"250m"},"limits":{"memory":"1Gi","cpu":"1"}}}]}}'
# pod/worker-0 patched

kubectl get pod worker-0 -o jsonpath='{.status.containerStatuses[0].restartCount}{"\n"}'
# 0

kubectl get pod worker-0 -o jsonpath='{.status.containerStatuses[0].resources}{"\n"}'
# {"limits":{"cpu":"1","memory":"1Gi"},"requests":{"cpu":"250m","memory":"512Mi"}}
restartCount не сдвинулся — значит, это действительно был in-place resize, а не быстрый рестарт, который легко спутать с ним по логам. Если бы на узле физически не хватило места под новый request, status.conditions под именем PodResizePending показал бы reason: Deferred вместо мгновенного применения — kubelet держит желаемое значение в spec, но не трогает cgroup, пока место не освободится (или пока resize не отменят обратным патчем).
Интеграция с Vertical Pod Autoscaler
VPA получил третий режим обновления — updateMode: InPlaceOrRecreate — который приоритетно бьёт в resize-subresource и только при неудаче откатывается на старое поведение:
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: worker-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: worker
  updatePolicy:
    updateMode: InPlaceOrRecreate
  resourcePolicy:
    containerPolicies:
      - containerName: worker
        minAllowed:
          cpu: 100m
          memory: 256Mi
        maxAllowed:
          cpu: 2
          memory: 4Gi
Порядок действий VPA под этим режимом:
- Recommender посчитал новую цель — пробуем
pods/resizeна текущем поде. - Kubelet принял: применяется на месте,
restartCountне растёт, под не покидает узел. - Kubelet отклонил как
Infeasible(новый request физически не влезает на текущий узел) илиresizePolicyтребует рестарта контейнера, а разница слишком велика — VPA откатывается на старое поведение: evict пода и пересоздание с новыми значениями, как раньше делалupdateMode: Recreate.
Для оператора это значит, что InPlaceOrRecreate почти всегда безопаснее чистого Recreate — но не убирает необходимость мириться с редким пересозданием на переполненных узлах.
Что это меняет у scheduler и cluster-autoscaler
Самый тонкий эффект GA — не в самом резайзе, а в том, что происходит с уже прошедшим scheduling решением, когда requests меняются постфактум:
- Scheduler принимает решение о размещении один раз, в момент создания пода, на основе исходных
requests. In-place resize это решение не пересматривает — увеличенный request не запускает повторный scheduling. Вместо этого kubelet на конкретном узле сверяет новый request с локально доступной ёмкостью (allocatable минус то, что уже занято другими подами) и либо применяет сразу, либо ставитPodResizePendingсDeferred. - Cluster Autoscaler реагирует не на факт resize, а на его последствия: если под из-за
Deferredзавис в ожидании места, CA увидит это как обычный unschedulable-сигнал (в данном случае — «не помещается на существующие узлы») и попробует поднять новый узел. Но CA должен знать актуальныеrequests, а не те, что были на момент последнего скейлинга — начиная с версий CA, синхронизированных с этим GA, он читаетspec.containers[].resources, а не кэширует исходные значения из создания пода. - Bin-packing деградирует со временем без controller. Если много подов подряд ужимают себя вниз через resize, но остаются на узлах, где были запланированы с более крупным исходным request, кластер постепенно теряет плотность упаковки — освободившееся место не triggers descheduling само по себе. Дескедулер (
deschedulerс политикойLowNodeUtilization) остаётся отдельным механизмом, который стоит держать рядом, если VPA активно ужимает поды in-place.
Сравнение: было / стало
| Параметр | До in-place resize (≤1.26 и без feature gate) | С GA in-place resize (1.35+) |
|---|---|---|
| Изменение CPU у running-пода | пересоздание пода целиком | resize-subresource, без рестарта контейнера |
| Изменение memory limit вверх (cgroups v2) | пересоздание пода целиком | resize-subresource, без рестарта контейнера |
| Изменение memory limit вниз (cgroups v1) | пересоздание пода целиком | всё ещё требует RestartContainer |
| IP пода / локальный кэш процесса | теряются при пересоздании | сохраняются — под не покидает узел |
| VPA update mode | Off / Initial / Recreate | + InPlaceOrRecreate с фолбэком на recreate |
| Смена QoS-класса ресайзом | невозможна (весь под пересоздаётся с новым классом) | по-прежнему невозможна — апи-сервер отклоняет патч |
| Влияние на scheduler | новое scheduling-решение при каждом изменении | без пересмотра, kubelet сверяет допустимость локально |
Что нужно, чтобы включить это у себя
- Kubernetes 1.35+ на control plane и kubelet — GA означает feature gate
InPlacePodVerticalScalingвключён по умолчанию, отключать его вручную не нужно. - cgroups v2 на всех узлах, где планируется уменьшать
memory.limit. Это главный практический чек-лист пункт: если в кластере остались узлы на cgroups v1 (старые образы, legacycgroupDriver), resize памяти вниз на них будет форсированно рестартовать контейнер — фича не сломается, но тихо откатится на старое поведение именно там, где вы её не ждали. - CRI-рантайм, поддерживающий resize без рестарта — containerd 1.7+/2.x и CRI-O актуальных версий это умеют; на более старых рантаймах kubelet будет вынужден идти через
RestartContainerнезависимо отresizePolicy. resizePolicyв спеке контейнера, если дефолтное поведение не подходит — например, явно поставитьRestartContainerдля памяти у процессов с собственным аллокатором, который не отдаёт память ОС сам.- RBAC на
pods/resizeотдельно отpods— если резайзить ресурсы будет VPA или внешний контроллер, а не человек черезkubectl, включите это право явно в егоClusterRole.
Как проверить, что резайз действительно прошёл in-place
kubectl get pod worker-0 -o jsonpath='{.status.containerStatuses[0].restartCount}{"\n"}'
# restartCount не изменился — значит, resize применился без пересоздания контейнера

kubectl get pod worker-0 -o jsonpath='{.status.conditions[?(@.type=="PodResizePending")]}{"\n"}'
# пусто, если resize применился сразу; {"reason":"Deferred",...} — если под ждёт места на узле

kubectl get pod worker-0 -o jsonpath='{.status.containerStatuses[0].resources}{"\n"}'
# фактические cpu/memory limits и requests, применённые в cgroup прямо сейчас
Если restartCount вырос сразу после патча — resize сработал через RestartContainer, а не через тихое применение на лету; проверьте resizePolicy контейнера и то, на каком cgroup-драйвере находится узел.
Итог
In-Place Pod Resize закрывает целый класс ненужного pod churn’а — но только там, где вы заранее проверили, что под ним действительно cgroups v2 и современный CRI, а не унаследованный узел, который тихо откатит фичу на рестарт именно тогда, когда это будет незаметно. Если ваш стек полагается на рестарт контейнера как побочный способ сбросить утёкшую память — VPA в режиме InPlaceOrRecreate эту привычку не одобрит, он просто перестанет её вызывать без необходимости. Прежде чем включать resize повсеместно, стоит явно решить, где resizePolicy должен остаться RestartContainer, а не унаследовать дефолт молча.