

Канарейка с автоматическим откатом долго была привилегией кластеров с service mesh: резать живой трафик по процентам умели VirtualService в Istio и SMI-сплиты в Linkerd, а у кого mesh не было — выкручивались аннотациями ingress-контроллера. Argo Rollouts это ограничение снял: официальный плагин trafficrouter-gatewayapi режет трафик прямо в стандартном HTTPRoute, а AnalysisTemplate по метрикам Prometheus сам решает — продвигать релиз или откатывать. Service mesh не нужен, нужен Gateway API, который в 2026 году уже есть почти у всех.
Почему сейчас: начиная с Rollouts 1.9 плагин поддерживает maxTrafficWeight — шкалу весов можно растянуть до миллиона и резать трафик тоньше 1%, а экосистема (Cilium, kgateway, VPC Lattice) строит интеграции поверх Gateway API. Прогрессивная доставка переехала с mesh-специфичных ресурсов на стандартный API кластера, и порог входа рухнул.
Содержание
Открыть содержание
Rollout вместо Deployment: что меняется
Deployment со стратегией RollingUpdate заменяет поды по расписанию и никогда не спрашивает метрики — эту проблему мы подробно разбирали в статье про Flagger. Argo Rollouts решает её на уровне манифеста: вместо Deployment вы описываете Rollout — тот же pod template, но стратегия canary с явными шагами. Совместимость с Argo CD из коробки: для GitOps-пайплайна это просто ещё один CRD в git.
В канареечном режиме Rollout держит два ReplicaSet — стабильный и canary — и два Service с одинаковым селектором: web-stable и web-canary. Нет, они не выберут одни и те же поды: Rollout сам вешает подам каждого ReplicaSet метку rollouts-pod-template-hash, поэтому стабильный Service цепляет старые поды, canary — новые. А трафик между ними режет не kube-proxy, а Gateway — по весам в HTTPRoute с двумя backendRefs:
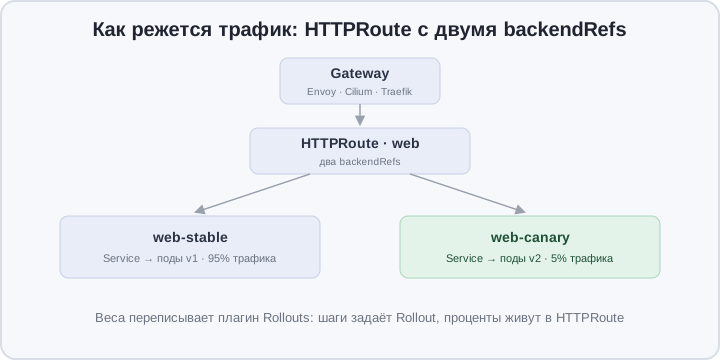
Ключевая механика: плагин argoproj-labs/gatewayAPI внутри контроллера переписывает поле weight у обоих backendRefs, когда Rollout переходит на следующий шаг. Gateway — Envoy Gateway, Cilium, Traefik, kgateway, любой, реализующий Gateway API v1 — честно исполняет проценты. В git лежит манифест без весов; фактическое состояние меняет контроллер: шаги декларативны, исполнение автоматическое.
AnalysisTemplate: метрики, которые валят релиз
Сдвиг трафика — половина канарейки. Вторая половина — решение «продвигать или нет», и его Argo Rollouts тоже забирает у человека. AnalysisTemplate — это CR с описанием метрики: какой запрос гонять в Prometheus, как часто, при каком значении измерение считается проваленным и сколько провалов терпим.
Когда Rollout доходит до шага analysis, создаётся объект AnalysisRun, который блокирует дальнейшее продвижение: каждые interval он выполняет запрос и сверяет результат с условием. Проваленных измерений больше failureLimit — AnalysisRun помечается Failed, Rollout уходит в abort: плагин мгновенно возвращает 100% веса на стабильный backendRef, canary-поды масштабируются в ноль, статус Rollout — Degraded. Никакого kubectl rollout undo в 3 часа ночи — откат делает контроллер за секунды.
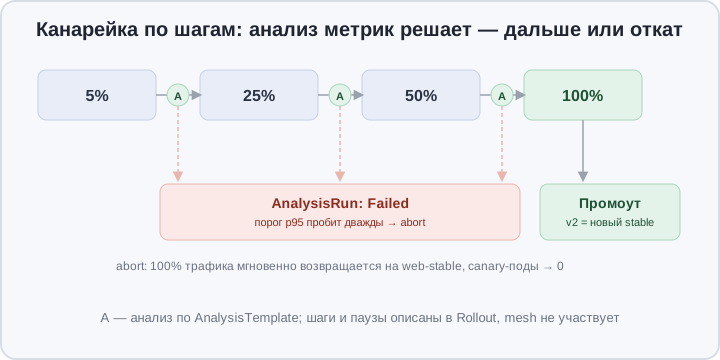
Метрики не обязаны быть инфраструктурными: запрос — произвольный PromQL, так что порогом может быть доля успешных оплат или конверсия, а не только p95 и error-rate.
Сравнение в одной таблице
Deployment + RollingUpdate | Rollout + Gateway API | |
|---|---|---|
| Сдвиг трафика | по мере готовности подов | шагами 5 → 25 → 50 → 100% через HTTPRoute |
| Анализ метрик | нет, только алерты постфактум | AnalysisRun на каждом шаге |
| Решение об откате | человек по алерту | контроллер по порогу из git |
| Минимальный blast-radius | ~25% трафика (maxUnavailable) | 5% или тоньше |
| Service mesh | не нужен, но и сплитов нет | не нужен — режет стандартный HTTPRoute |
| GitOps | образ в git, дальше вслепую | те же манифесты + Argo CD из коробки |
| Откат | минуты и человек | секунды и контроллер |
Что нужно, чтобы поднять канарейку
Предусловия: кластер с реализацией Gateway API v1 (Envoy Gateway, Cilium, Traefik, kgateway) и Prometheus с метриками приложения. Дальше четыре шага.
1. Контроллер, CLI и плагин. Ставим Argo Rollouts и kubectl-плагин:
kubectl create namespace argo-rollouts
kubectl apply -n argo-rollouts \
  -f https://github.com/argoproj/argo-rollouts/releases/latest/download/install.yaml
kubectl krew install rollouts
Плагин подключается через ConfigMap с фиксированным именем argo-rollouts-config:
apiVersion: v1
kind: ConfigMap
metadata:
  name: argo-rollouts-config   # имя фиксировано
  namespace: argo-rollouts
data:
  trafficRouterPlugins: |-
    - name: "argoproj-labs/gatewayAPI"
      location: "https://github.com/argoproj-labs/rollouts-plugin-trafficrouter-gatewayapi/releases/download/v0.5.0/gatewayapi-plugin-linux-amd64"
Применить, перезапустить контроллер (kubectl -n argo-rollouts rollout restart deployment argo-rollouts) и проверить в логах строку Downloading plugin argoproj-labs/gatewayAPI. Для офлайн-кластеров есть вариант с init-контейнером и образом из ghcr.io — см. документацию плагина.
2. RBAC. Плагину нужны права читать Services и патчить HTTPRoute (и GRPCRoute, если используете):
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: argo-rollouts-gatewayapi
rules:
  - apiGroups: [""]
    resources: [services]
    verbs: [get]
  - apiGroups: [gateway.networking.k8s.io]
    resources: [httproutes, grpcroutes]
    verbs: [get, list, patch, update]
Свяжите роль с ServiceAccount argo-rollouts через ClusterRoleBinding — и всё, кластер готов.
3. Два Service и HTTPRoute. Селекторы одинаковые — разрулит Rollout:
apiVersion: v1
kind: Service
metadata:
  name: web-stable
  namespace: prod
spec:
  selector: { app: web }
  ports: [{ port: 80, targetPort: http }]
---
apiVersion: v1
kind: Service
metadata:
  name: web-canary
  namespace: prod
spec:
  selector: { app: web }
  ports: [{ port: 80, targetPort: http }]
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: web
  namespace: prod
spec:
  parentRefs: [{ name: eg }]
  rules:
    - matches: [{ path: { type: PathPrefix, value: / } }]
      backendRefs:
        - { name: web-stable, kind: Service, port: 80 }
        - { name: web-canary, kind: Service, port: 80 }
Веса в манифесте не указаны — их допишет плагин при первом же rollout.
4. AnalysisTemplate и сам Rollout. Шаблон анализа p95 с failureLimit: 2:
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: p95-latency
  namespace: prod
spec:
  args:
    - name: service
  metrics:
    - name: p95
      interval: 1m
      count: 3
      failureLimit: 2
      failureCondition: result[0] >= 500
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            histogram_quantile(0.95,
              sum by (le) (rate(http_request_duration_seconds_bucket
                {service="{{args.service}}", version="canary"}[2m]))
            ) * 1000
Три замера с интервалом в минуту; два замера хуже 500 мс — и AnalysisRun валится в Failed. Теперь Rollout с шагами 5/25/50/100:
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: web
  namespace: prod
spec:
  replicas: 10
  selector: { matchLabels: { app: web } }
  template:
    metadata: { labels: { app: web } }
    spec:
      containers:
        - name: web
          image: registry.example.com/web:v1
          ports: [{ name: http, containerPort: 8080 }]
  strategy:
    canary:
      stableService: web-stable
      canaryService: web-canary
      maxSurge: 1
      maxUnavailable: 0
      trafficRouting:
        plugins:
          argoproj-labs/gatewayAPI:
            httpRoute: web
            namespace: prod
      steps:
        - setWeight: 5
        - pause: { duration: 2m }
        - analysis:
            templates: [{ templateName: p95-latency }]
            args: [{ name: service, value: web }]
        - setWeight: 25
        - pause: { duration: 5m }
        - analysis:
            templates: [{ templateName: p95-latency }]
            args: [{ name: service, value: web }]
        - setWeight: 50
        - pause: { duration: 5m }
        - analysis:
            templates: [{ templateName: p95-latency }]
            args: [{ name: service, value: web }]
        - setWeight: 100
Каждый шаг — поднять вес, дать метрикам накопиться, спросить Prometheus. Хотите ручной гейт — вставьте pause: {} без duration: Rollout замрёт и будет ждать kubectl argo rollouts promote. А если нужна точность тоньше процента, добавьте в trafficRouting поле maxTrafficWeight: 10000 (Rollouts 1.9+): шаг setWeight: 100 станет означать 1% трафика.
Как проверить авто-откат
Прогон на «сломанном» релизе — единственная честная проверка. Деплоим версию, которая укладывает p95:
kubectl argo rollouts set image web web=registry.example.com/web:v2-broken
kubectl argo rollouts get rollout web -n prod --watch
Ожидаемая картина: вес поднимается до 5%, пауза, AnalysisRun делает замеры; на третьем замере (два провальных при failureLimit: 2) статус меняется на Failed, Rollout — на Degraded, стрелка веса возвращается на 0. Сверьте фактическое состояние маршрута:
kubectl -n prod get httproute web -o jsonpath='{.spec.rules[0].backendRefs}'После отката там 100/0 — весь трафик снова на web-stable. События с причиной (kubectl -n prod describe rollout web) покажут, какая метрика и насколько превысила порог. Годовая практика: такой негативный прогон стоит гонять после каждой смены порогов — AnalysisTemplate, который ни разу не валял релиз, вы не проверяли.
Rollouts или Flagger
Мы уже писали о Flagger — это ближайший и равноценный конкурент, тоже без mesh, тоже на Gateway API. Честная разница такая. Flagger оборачивает существующий Deployment, не меняя его вид, — миграция нулевая; у него встроенные webhook-нагрузочные тесты и родная экосистема Flux. Rollouts заменяет Deployment на собственный CR — миграция касается манифеста, зато шаги с паузами и ручными гейтами описываются явно, AnalysisRun — отдельный переиспользуемый объект, есть blue-green и Experiment, kubectl-плагин с живым UI. Практическое правило: у вас Flux и «не трогайте Deployment» — берите Flagger; у вас Argo CD и нужны паузы с ручным промоутом — Rollouts. Оба дают одно и то же главное: откат за секунды по метрикам вместо отката за минуты по пейджеру.
Грабли
- Плагин не скачался. Контроллер перезапустили до применения ConfigMap, или кластер не пускает на GitHub — смотрите логи: строка
Downloading plugin argoproj-labs/gatewayAPIобязательна. Офлайн — init-контейнер изghcr.io. - Старая реализация Gateway API. Плагин 0.3+ работает с ресурсами
gateway.networking.k8s.io/v1; реализации на допотопных v1beta1 поддерживает только релиз плагина 0.2.0. Сверяйтесь со страницей provider-status перед выбором шлюза. - Пустой ответ Prometheus. Если на canary нет трафика, запрос вернёт пустой массив — это Error, а не Failed; ошибки копятся отдельно и после четырёх подряд тоже валят анализ. На низкопроцентных шагах фильтруйте метрику по версии, а не по поду.
- Argo CD воюет за веса. Пока канарейка идёт, плагин помечает HTTPRoute меткой
rollouts.argoproj.io/gatewayapi-canary=in-progress; настройтеignoreDifferencesдля HTTPRoute в Argo CD (jq-выражение по этой метке), иначе каждый sync будет откатывать веса до состояния из git.
Итог
Mesh для канареек больше не обязателен: любой кластер с Gateway API получает полный цикл progressive delivery — шаги, паузы, метрики и авто-откат — ценой одного контроллера и плагина. Плата: замена Deployment на Rollout, RBAC для плагина и аккуратный ignoreDifferences для Argo CD. Отдача: сломанный релиз видят 5% пользователей вместо всех, а откат происходит по порогу из git за секунды — без дежурного с пейджером. Если Gateway API у вас уже стоит, попробовать можно за один вечер.