

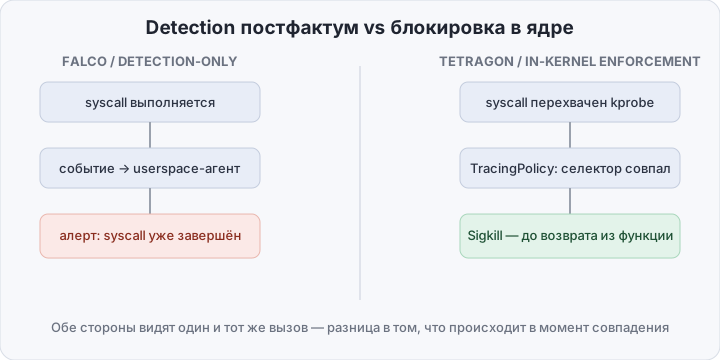
Falco, Tracee и большинство eBPF-инструментов security-мониторинга умеют одно: заметить, что что-то произошло, и отправить алерт — уже после того, как syscall выполнился и данные, возможно, успели уйти из хоста. Tetragon, eBPF-движок runtime-безопасности из проекта Cilium, умеет больше: остановить процесс синхронно в ядре в тот момент, когда сработал kprobe, — до того, как syscall вообще успеет вернуть управление вызвавшему коду. Разбираем, из чего собирается TracingPolicy, чем блокировка в ядре отличается от постфактум-алерта и почему включать Sigkill в первый же день — это способ положить продакшен, а не защитить его.
Содержание
Открыть содержание
От алерта к Sigkill: зачем ещё один eBPF-инструмент безопасности
Detection-only — это не недостаток конкретного инструмента, а архитектурное ограничение целого класса решений. Falco цепляет kprobes и tracepoints, собирает события в userspace, прогоняет их через правила и в случае совпадения шлёт уведомление — в Slack, в SIEM, куда угодно. К моменту, когда это уведомление кто-то прочитает (или даже когда его обработает автоматика), исходный syscall давно завершился: файл прочитан, шелл запущен, соединение установлено. Detection здесь работает как камера видеонаблюдения — отличный источник для расследования инцидента постфактум, но не физическая преграда в момент, когда происходит нарушение.
Tetragon устроен иначе не потому, что использует другой eBPF-хук, а потому, что действие можно привязать прямо к точке перехвата: TracingPolicy с действием Sigkill завершает процесс синхронно, из ядра, прежде чем управление вернётся из перехваченной функции обратно в вызывающий код. Разница не в скорости реакции — счёт не идёт на миллисекунды алертинга против миллисекунд блокировки, — а в том, что до записи в лог событие для Tetragon уже необратимо предотвращено, а не просто зафиксировано.
Почему это стоит разбирать именно сейчас, а не когда Tetragon только анонсировали: за 2026 год проект прошёл путь от версии 1.4 (февраль), которая заметно упростила написание и отладку TracingPolicy — до неё авторам политик приходилось куда больше гадать, почему селектор не матчится, — до 1.7 (апрель) с более зрелым инструментарием вокруг enforcement. Это не «фича неделю как в бете» — это инструмент, который за пару релизов дошёл до состояния, когда включать блокировку в проде уже не авантюра, если делать это по правильному паттерну раскатки (о нём — ниже).
Анатомия TracingPolicy: из чего собирается правило
TracingPolicy — кастомный ресурс (apiVersion: cilium.io/v1alpha1, kind: TracingPolicy), который описывает три вещи: где перехватывать, что сравнивать и что делать при совпадении.
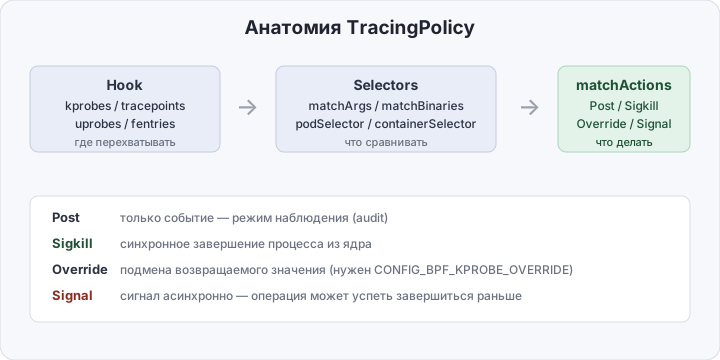
Точка перехвата — один из нескольких типов хуков: kprobes (функции ядра и системные вызовы), tracepoints (заранее определённые точки в ядре, более стабильные между версиями, чем произвольные символы), uprobes (функции в userspace-бинарниках) и более редкие fentries/lsmhooks/usdts. Для практики важнее всего kprobes — именно на них строится почти любая политика runtime-безопасности: перехват execve для контроля запуска процессов, перехват операций с файловыми дескрипторами для контроля доступа к файлам.
Селекторы — фильтрация внутри хука, без которой пришлось бы ловить вообще все вызовы функции по всему кластеру:
matchArgs— сравнение аргументов вызова по индексу и оператору:Equal,NotEqual,Prefix,Postfix,Mask,FileType,NotFileType. ИменноmatchArgsотличает «заблокировать любойexecve» от «заблокироватьexecveконкретно/bin/sh»;matchBinaries— фильтр по бинарнику, который сделал вызов (operator: In+ список путей), с опциейfollowChildren, чтобы захватить и процессы, порождённые уже после установки политики;podSelector/containerSelector— Kubernetes-native фильтрация по labels пода и по имени/репозиторию контейнера внутри пода; без неё политика применяется ко всем workload’ам в кластере одновременно, что почти никогда не нужно на старте.
matchActions — то, что происходит при совпадении всех условий селектора. Post — просто сгенерировать событие (это и есть режим наблюдения); Sigkill — синхронно убить процесс из ядра; Override — подменить возвращаемое значение вызова (требует поддержки CONFIG_BPF_KPROBE_OVERRIDE в ядре) и передать управление дальше так, будто функция вернула, например, -EPERM; Signal — отправить произвольный сигнал, но асинхронно — операция может успеть завершиться до того, как процесс получит и обработает сигнал, поэтому для жёсткой блокировки полагаться на Signal не стоит, это скорее мягкое уведомление процессу, чем гарантия остановки.
Runtime vs deploy-time: где Tetragon стоит рядом с admission-контролем
Легко перепутать Tetragon с admission-контролем вроде Kyverno или ValidatingAdmissionPolicy — оба в итоге «блокируют что-то нехорошее в Kubernetes». Разница — в моменте, а не в строгости.
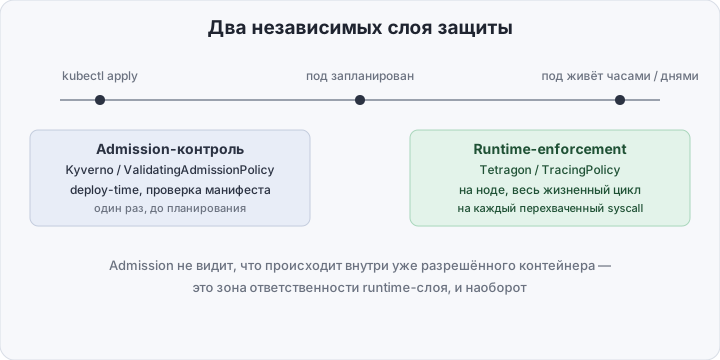
Admission-контроль — это deploy-time: kube-apiserver проверяет объект в момент kubectl apply, до того как под вообще запланирован на ноду. ValidatingAdmissionPolicy или Kyverno отлично отловят под, который просит hostPath, работает от root или тянет образ с тегом :latest, — но они ничего не знают про то, что происходит внутри уже разрешённого и запущенного контейнера через десять минут после старта. Если в зависимость легитимного образа кто-то протащил supply-chain-компрометацию, которая на старте выглядит безобидно, а посреди рабочего дня пытается развернуть /bin/sh и утащить переменные окружения наружу, — admission-контроль это событие просто не увидит: под уже прошёл проверку и живёт своей жизнью.
Tetragon работает на другом слое — runtime, на уровне ноды, весь жизненный цикл контейнера, а не только момент его создания. Он не знает и не обязан знать, соответствует ли манифест пода политике безопасности организации, — зато видит каждый execve, каждую операцию с файловым дескриптором, каждый перехваченный syscall внутри уже работающего контейнера. Это ровно то место, куда admission-контроль структурно не дотягивается: не потому, что Kyverno или VAP написаны слабо, а потому, что они не запускаются повторно на каждый syscall внутри уже живого пода — и не должны, иначе admission стал бы узким местом для всего рантайма кластера. Правильная модель — не «который из двух выбрать», а два независимых слоя защиты: один держит периметр входа в кластер, второй — то, что происходит внутри после входа.
Таблица сравнения
| Параметр | Falco / detection-only | Tetragon Sigkill/Override | Admission-контроль (Kyverno/VAP) |
|---|---|---|---|
| Момент действия | после завершения syscall | до возврата из перехваченной функции | до создания объекта в API |
| Что видит | процессы, файлы, сеть на ноде | то же, но с правом действия | манифест ресурса |
| Реакция на совпадение | алерт в userspace | блокировка в ядре | reject запроса к API |
| Риск ложного срабатывания | шумный алерт | убитый легитимный процесс | отклонённый деплой |
| Защищает от | известной активности постфактум | эксплуатации уже внутри контейнера | небезопасного манифеста на входе |
| Требует ядра с eBPF | да | да | нет |
Что нужно, чтобы раскатить политику по правилам
Задача: заблокировать запуск /bin/sh и /bin/bash внутри контейнеров с меткой security.hogin.pro/immutable: "true" — типичный случай для сервисов, которым интерактивный шелл вообще не нужен ни при каких обстоятельствах.
Сначала — политика без enforcement, только наблюдение:
apiVersion: cilium.io/v1alpha1
kind: TracingPolicy
metadata:
  name: "block-shell-in-immutable"
spec:
  podSelector:
    matchLabels:
      security.hogin.pro/immutable: "true"
  kprobes:
  - call: "sys_execve"
    syscall: true
    args:
    - index: 0
      type: "string"
    selectors:
    - matchArgs:
      - index: 0
        operator: "Prefix"
        values:
        - "/bin/sh"
        - "/bin/bash"
      matchActions:
      - action: "Post"
matchActions: [Post] здесь — это и есть audit-режим: селектор уже полностью настроен и матчится ровно на те же события, что впоследствии будет блокировать, но пока только генерирует событие, ничего не останавливая. Применяем и смотрим поток совпадений через tetra:
kubectl apply -f block-shell-in-immutable.yaml

tetra getevents -o compact --namespace prod \
  --pod-labels security.hogin.pro/immutable=true
# 🚀 process   prod/api-6f9. /bin/sh -c "healthcheck.sh"
# 💥 exit      prod/api-6f9. /bin/sh     0
Именно на этом шаге чаще всего всплывает то, ради чего вообще существует audit-режим: healthcheck-скрипт, sidecar или CI-раннер, который дергает /bin/sh легитимно и о котором никто не вспомнил на этапе проектирования политики. Здесь есть два honest-варианта: сузить podSelector/containerSelector, исключив такие контейнеры из-под действия политики, либо признать, что метка immutable на этом workload’е была навешена преждевременно. Оба варианта лучше, чем узнать про этот /bin/sh в момент, когда Sigkill уже убил healthcheck и под пошёл в перезапуск по CrashLoopBackOff.
Когда поток событий за наблюдаемый период (реалистично — от нескольких дней до недели-двух под реальной нагрузкой, а не пяти минут на стейджинге) не показывает ничего, кроме подтверждённо нежелательной активности, — меняем matchActions в той же политике:
      matchActions:
      - action: "Sigkill"
kubectl apply -f block-shell-in-immutable.yamlСтруктура политики, селекторы, podSelector — всё осталось прежним. Изменилось одно действие в одном месте. Это и есть весь смысл паттерна: audit и enforcement — это не два разных ресурса и не два режима работы Tetragon, а одна и та же политика с разным matchActions, что делает переключение обратимым и локальным изменением, а не миграцией на другую систему.
Как проверить, что политика работает
kubectl exec -n prod api-6f9xy -- /bin/sh -c "echo test"
# command terminated with exit code 137

tetra getevents -o compact --namespace prod
# 🚀 process   prod/api-6f9. /bin/sh -c "echo test"
# 💀 kill      prod/api-6f9. /bin/sh                    SIGKILL
Exit-код 137 (128 + сигнал 9) и событие kill с SIGKILL в потоке Tetragon подтверждают, что блокировка сработала синхронно из ядра, а не через отложенный внешний контроллер. Легитимный трафик того же пода — HTTP-запросы, здоровый execve разрешённых бинарников — идёт как обычно: политика матчится только на sys_execve с аргументом, начинающимся на /bin/sh или /bin/bash, и не трогает ничего за пределами этого условия.
Итог
eBPF runtime-security перестаёт быть красивым источником логов ровно в тот момент, когда matchActions в TracingPolicy переключают с Post на Sigkill — но это переключение нужно заслужить периодом наблюдения на реальном трафике, а не включить в первый день из энтузиазма. Tetragon не заменяет admission-контроль вроде Kyverno или VAP и не заменяется им — они защищают разные моменты жизни workload’а, вход в кластер и то, что происходит после него, и по-хорошему должны работать вместе. Цена enforcement на уровне ядра реальна: неправильно откалиброванный селектор убивает не атакующего, а ваш собственный healthcheck. Плата за это — возможность остановить эксплуатацию до того, как она успеет что-то сделать, а не написать про неё пост-мортем.