

В блоге релиза Kubernetes v1.35 это написано прямым текстом: 1.35 — последняя минорная версия, которая ещё поддерживает узлы на containerd 1.x. Перед апгрейдом до 1.36 каждая нода обязана перейти на containerd 2.0+. Формально это звучит как строчка в release notes рядом с десятком других deprecation. На практике это отдельный роллаут по всему кластеру с несовместимым форматом конфига, переименованными плагинами и другим поведением GPU — и его стоит планировать заранее, а не за неделю до апгрейда control plane.
Содержание
Открыть содержание
- Почему это не рядовой минорный апгрейд
- config.toml version 2 → version 3: несовместимый формат
- Что проверять через
containerd config dump - CDI и GPU: другое поведение device plugin
- containerd 1.7 vs containerd 2.0: что реально поменялось
- Что нужно, чтобы выкатить переход без простоя
- Откат, если canary не прошла
- Как проверить, что нода готова
- Итог
Почему это не рядовой минорный апгрейд
containerd 2.0 вышел ещё в конце 2024 года как первый major-релиз проекта после 1.0, и с тех пор жил параллельно с веткой 1.7 — большинство managed-кластеров (EKS, GKE, AKS) до последнего держали 1.7 как безопасный дефолт. Version skew policy Kubernetes такого параллельного существования больше не гарантирует: 1.35 — последний релиз, который тестируется и поддерживается на containerd 1.x, 1.36 требует 2.0+ на каждом узле, который к нему присоединяется. Это значит, что переход перестаёт быть опциональным «когда-нибудь обновим runtime» и становится жёсткой предпосылкой для следующего апгрейда control plane.
Проблема не в самом бинарнике — замена пакета containerd через apt/yum занимает секунды. Проблема в том, что 2.0 не читает старый конфиг так, как его читала 1.7, часть CRI-плагина устроена по-другому, а GPU-нагрузки на CDI могут начать вести себя иначе без единой строчки в логах, если не проверить это заранее.
Отдельная сложность в том, что симптомы неудачной миграции почти никогда не проявляются сразу на самом узле. containerd стартует, systemctl status containerd зелёный, kubelet подключается к CRI-сокету и репортит узел Ready — с точки зрения control plane всё нормально. Реальная проблема всплывает на следующем поде, который планировщик посадит на этот узел: ImagePullBackOff из-за не подхватившегося приватного registry, под без GPU-устройства, хотя nvidia.com/gpu в лимитах есть, или неожиданно другой sandbox_image, который тянется заново для каждого нового пода. Именно поэтому проверка через containerd config dump до переключения узла в продовый трафик дешевле, чем разбор инцидента после.
config.toml version 2 → version 3: несовместимый формат
containerd конфигурируется через /etc/containerd/config.toml с полем version в шапке файла. Version 1 не читается уже давно, version 2 была дефолтом всей ветки 1.x. containerd 2.0 требует version 3 — и это не косметическое изменение номера, а другая схема путей плагинов.
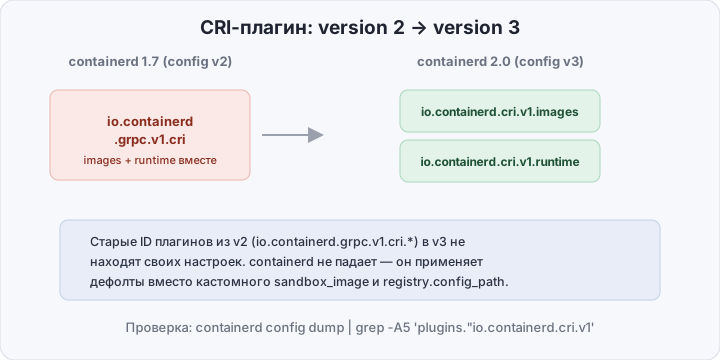
Главное изменение: монолитный CRI-плагин io.containerd.grpc.v1.cri, который в 1.x отвечал одновременно за pull образов и за запуск контейнеров, в 2.0 разделён на два независимых плагина с собственными ID:
# containerd 1.7, config version 2
[plugins."io.containerd.grpc.v1.cri"]
  sandbox_image = "registry.k8s.io/pause:3.10"
  [plugins."io.containerd.grpc.v1.cri".containerd]
    default_runtime_name = "runc"
  [plugins."io.containerd.grpc.v1.cri".registry]
    config_path = "/etc/containerd/certs.d"
# containerd 2.0, config version 3
version = 3
[plugins."io.containerd.cri.v1.images"]
[plugins."io.containerd.cri.v1.images".pinned_images]
sandbox = "registry.k8s.io/pause:3.10"
[plugins."io.containerd.cri.v1.runtime"]
[plugins."io.containerd.cri.v1.runtime".containerd]
default_runtime_name = "runc"
[plugins."io.containerd.grpc.v1.cri".registry]
config_path = "/etc/containerd/certs.d"Если просто заменить пакет и оставить старый config.toml как есть, containerd 2.0 не упадёт с ошибкой парсинга — version 2 всё ещё принимается, — но плагины под старыми ID io.containerd.grpc.v1.cri.* тихо не найдут своих настроек, и containerd применит дефолты вместо того, что вы явно задавали: свой sandbox_image, кастомный registry.config_path, лимиты runtime. Узел поднимется, kubelet подключится к CRI-сокету — а поведение будет незаметно другим, пока кто-то не заметит, что приватный registry перестал резолвиться.
Правильная последовательность — не редактировать config.toml руками по памяти, а сгенерировать актуальный дефолт и перенести в него свои значения:
containerd config default > /etc/containerd/config.toml.new
diff /etc/containerd/config.toml /etc/containerd/config.toml.new
diff на реальном узле обычно показывает 30-40 строк изменений даже при минимальной кастомизации — это ожидаемо, не повод откатываться.
Что проверять через containerd config dump
containerd config default показывает дефолт — то, что будет, если конфига нет вообще. Чтобы увидеть, что containerd реально применил после старта (дефолты плюс ваш config.toml, слитые воедино), нужна другая команда:
containerd config dump | grep -A5 'plugins."io.containerd.cri.v1'Три вещи, которые стоит сверить построчно перед тем, как переключать узел в продовый node pool:
sandbox_image— если он не совпадает с тем, что было в 1.7, kubelet начнёт тянуть другой образ паузы для каждой новой пода на узле.registry.config_path— путь к per-registry TLS/auth конфигурации; при расхождении узел может не аутентифицироваться в приватном registry, и поды будут падать вImagePullBackOffтолько на этом конкретном узле.containerd.runtimes— список зарегистрированных container runtime classes (runc,kata,gvisorи так далее); плагин, который их не подхватил, — это узел, который не сможет запускать поды с соответствующимruntimeClassName.
Отдельно: часть плагинов, существовавших в 1.7 как deprecated-но-рабочие (legacy CRI v1alpha2 API, устаревший docker-schema1 image format, shim-адаптер под runtime v1), в 2.0 полностью удалена, а не просто выключена по умолчанию. Если у вас есть кастомный runtime handler или CI-раннер, который явно завязан на один из этих путей, containerd config dump их просто не покажет — и узнать об этом до переключения узла надёжнее, чем после.
CDI и GPU: другое поведение device plugin
Для узлов с GPU есть отдельная ловушка. В containerd 1.7 CDI (Container Device Interface) — механизм, которым NVIDIA device plugin инжектит GPU-устройства в контейнер, — был опциональной фичой, включаемой явно флагом enable_cdi = true под секцией CRI-плагина. Без этого флага NVIDIA device plugin падал обратно на старый механизм инжекции через runtime hook.
В containerd 2.0 CDI-инжекция — часть рантайма по умолчанию, а не опциональный флаг, и путь к CDI-спекам (cdi_spec_dirs) переехал из секции CRI-плагина в секцию самого runtime. Практическое следствие: если у узла с GPU в старом конфиге enable_cdi не был выставлен явно (то есть команда полагалась на дефолт 1.7 — CDI выключен, работает legacy hook-инжекция), после перехода на 2.0 поведение переключается на CDI автоматически, и NVIDIA device plugin версии, которая рассчитана на explicit-флаг, может начать конфликтовать по путям монтирования устройств с тем, что теперь делает сам containerd.
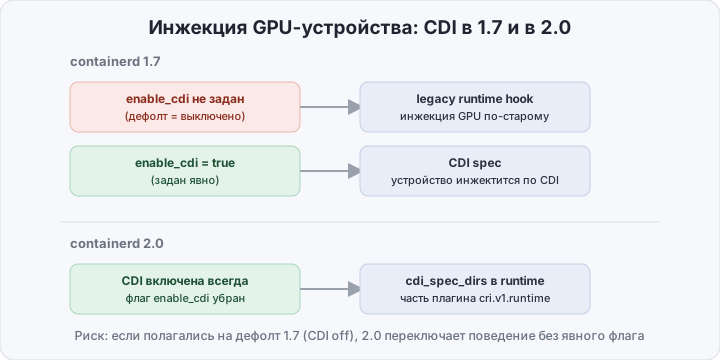
Практический чек-лист для GPU node pool: перед переключением зафиксировать версию NVIDIA device plugin, которая точно совместима с CDI по умолчанию (в первую очередь — проверить changelog самого device plugin на упоминание containerd 2.0), и прогнать хотя бы один smoke-под с nvidia.com/gpu: 1 в лимитах на canary-ноде до того, как переключать весь GPU-pool.
containerd 1.7 vs containerd 2.0: что реально поменялось
| Параметр | containerd 1.7 | containerd 2.0 |
|---|---|---|
| Версия конфига | version = 2 | version = 3, обязателен |
| CRI-плагин | один io.containerd.grpc.v1.cri | разделён на cri.v1.images и cri.v1.runtime |
| CDI для GPU | опционально, enable_cdi = true | включена по умолчанию, часть runtime |
| Legacy runtime v1 shim | deprecated, но работает | удалён |
docker-schema1 образы | deprecated, но работает | не поддерживаются |
| Поддержка в Kubernetes | до 1.35 включительно | обязателен с 1.36 |
Что нужно, чтобы выкатить переход без простоя
Нужен node pool, который можно обновлять частями (managed node group в EKS/GKE/AKS или собственный набор узлов за одним kubectl cordon-циклом), и как минимум одна нода, которую не жалко положить под canary. Стратегия — не «обновить containerd на всех узлах разом», а разделить node pool по версии containerd и катить партиями, начиная с canary-группы.
#!/usr/bin/env bash
set -euo pipefail

NODE="$1"

echo "== cordon & drain: $NODE =="
kubectl cordon "$NODE"
kubectl drain "$NODE" --ignore-daemonsets --delete-emptydir-data --timeout=180s

echo "== backup current config (needed for rollback) =="
ssh "$NODE" "sudo cp /etc/containerd/config.toml /etc/containerd/config.toml.bak"

echo "== replace containerd package =="
ssh "$NODE" "sudo apt-get install -y --only-upgrade containerd.io"

echo "== regenerate config: v2 -> v3 =="
ssh "$NODE" "sudo containerd config default | sudo tee /etc/containerd/config.toml.new"
ssh "$NODE" "sudo systemctl stop containerd"
ssh "$NODE" "sudo mv /etc/containerd/config.toml.new /etc/containerd/config.toml"
ssh "$NODE" "sudo systemctl start containerd"

echo "== verify CRI socket reachable by kubelet =="
ssh "$NODE" "sudo crictl --runtime-endpoint unix:///run/containerd/containerd.sock info | grep -q '\"status\": \"true\"' || (echo 'CRI socket not ready' && exit 1)"

echo "== uncordon =="
kubectl uncordon "$NODE"
echo "== done: $NODE =="
Порядок раскатки по node pool:
- Canary node group — 1-2 узла, изолированные
nodeSelector/taint от продовой нагрузки, обновляются первыми и держатся под наблюдением минимум сутки. - Smoke-тест на canary — под с обычным workload (без GPU) плюс, если есть GPU-узлы, отдельный под с
nvidia.com/gpuв лимитах — оба должны стартовать и пройти readiness без ручного вмешательства. - Разделение node pool по версии containerd — до полного роллаута часть узлов на 1.7, часть на 2.0 сосуществуют одновременно; это совместимо с текущей версией Kubernetes control plane (проверено вплоть до 1.35), но не должно длиться дольше, чем нужно на сам роллаут.
- Волнами по batch — по 10-20% узлов за раз, с паузой между волнами на проверку метрик (
ImagePullBackOff, рестарты подов, GPU-под алерты), а не всем pool сразу.
Откат, если canary не прошла
Роллаут по волнам с самого начала предполагает, что откат — не исключительная ситуация, а штатный шаг плана. Если canary-узел после перехода на 2.0 показал ImagePullBackOff, GPU-под не увидел устройство или containerd config dump разошёлся с ожидаемым — узел откатывается назад тем же путём, каким обновлялся, а не чинится на месте под давлением инцидента:
kubectl cordon "$NODE"
kubectl drain "$NODE" --ignore-daemonsets --delete-emptydir-data --timeout=180s
ssh "$NODE" "sudo apt-get install -y --allow-downgrades containerd.io=1.7.*"
ssh "$NODE" "sudo systemctl stop containerd"
ssh "$NODE" "sudo cp /etc/containerd/config.toml.bak /etc/containerd/config.toml"
ssh "$NODE" "sudo systemctl start containerd"
kubectl uncordon "$NODE"
Условие, без которого этот откат не сработает, — бэкап config.toml версии 2, снятый до первого запуска containerd config default на узле (cp /etc/containerd/config.toml /etc/containerd/config.toml.bak первой же строкой в скрипте роллаута, ещё до апгрейда пакета). Именно поэтому старый node pool стоит держать смешанным с новым какое-то время: пока хотя бы часть узлов работает на проверенной 1.7-конфигурации, у команды есть время разобрать причину сбоя на canary без давления «весь кластер уже переехал, откатываться некуда».
Как проверить, что нода готова
После uncordon минимальная проверка — что kubelet реально видит узел через новый CRI-сокет и версия containerd в Node.status.nodeInfo обновилась:
kubectl get node "$NODE" -o jsonpath='{.status.nodeInfo.containerRuntimeVersion}'
# ожидаем containerd://2.0.x, а не containerd://1.7.x
Дальше — запустить тестовый под именно на этой ноде (nodeName в манифесте) и убедиться, что он стартует и логирует ожидаемое:
kubectl run canary-check --image=busybox --overrides='{"spec":{"nodeName":"'"$NODE"'"}}' \
  --restart=Never -- sh -c 'echo ok'
kubectl logs canary-check
Если на узле есть GPU — отдельно прогнать под с nvidia.com/gpu: 1 и убедиться, что nvidia-smi внутри контейнера видит устройство: расхождение в CDI-поведении между 1.7 и 2.0 обычно проявляется именно здесь, а не на обычной нагрузке.
Итог
Переход на containerd 2.0 замаскирован под минорную деталь апгрейда до Kubernetes 1.36, но по факту это отдельный роллаут со своим форматом конфига, разделённым CRI-плагином и другим дефолтным поведением CDI для GPU. Разница между «сработает незаметно правильно» и «сработает незаметно неправильно» — это не запуск нового бинарника, а сверка containerd config dump построчно и canary-нода перед тем, как катить это на весь node pool. Дешевле потратить день на этот чеклист сейчас, чем разбирать инцидент с приватным registry или GPU-подами на проде после того, как control plane уже обновился до 1.36 и пути назад на 1.x официально нет.