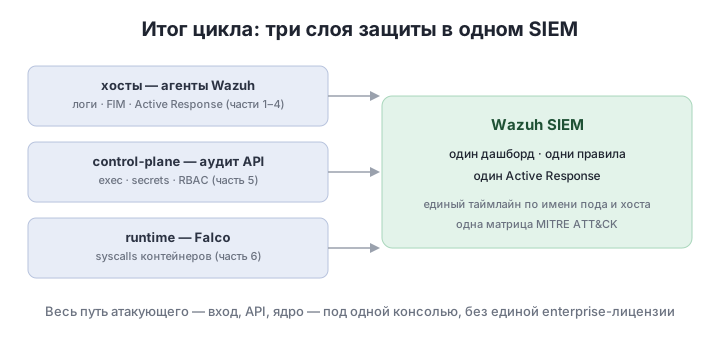
В пятой части SIEM добрался до control-plane Kubernetes: аудит API показал, кто сделал exec, кто прочитал secret и кто выдал себе права. Но у той картины осталась честная граница: API-сервер видит запросы, а не процессы. Что бинарник делает внутри пода после старта — какие файлы открывает, куда подключается, что запускает — на уровне API не видно ничего. Финал цикла закрывает эту дыру: ставим в кластер Falco, который перехватывает syscalls в ядре ноды, пишем свои правила и заводим алерты в тот же Wazuh — чтобы хосты, control-plane и runtime сходились в один дашборд.
Содержание
Открыть содержание
Что такое Falco и где он стоит
Falco — runtime-детектор от CNCF: первый проект класса runtime security, дошедший до статуса graduated (февраль 2024), с живыми релизами — v0.44.x на момент написания — и продакшн-историями уровня Shopify и GitLab. Разворачивается он как DaemonSet: по одному поду на каждую ноду, и этого достаточно, чтобы видеть все контейнеры ноды — свои, чужие и запущенные мимо вашего CI.
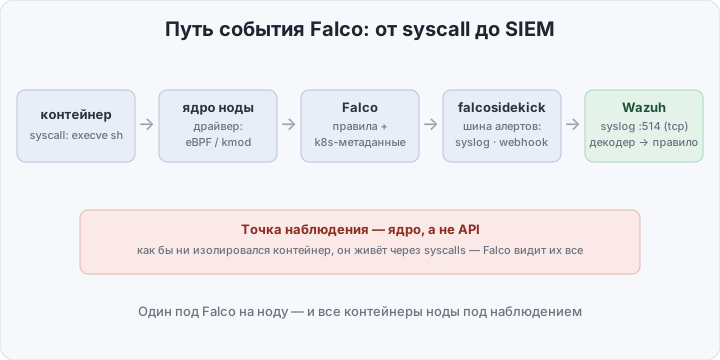
Ключ к пониманию Falco — точка наблюдения. Контейнер, как бы он ни изолировался, живёт через ядро: execve запускает процесс, open открывает файл, connect устанавливает соединение — и всё это syscalls. Драйвер Falco, встроенный в ядро ноды, получает этот поток целиком, движок прогоняет каждое событие через правила, а параллельный обогатитель ходит в API-сервер и добавляет контекст: рядом с proc.name=sh в алерте оказываются container.image.repository и k8s.pod.name. Не «какой-то процесс что-то сделал», а «вот этот образ, в этом поде, в этом неймспейсе».
Драйвер: eBPF или kernel-модуль
Чтобы перехватывать syscalls, Falco нужен кусок кода в ядре — драйвер. Варианта три, и выбор сводится к тому, какие ядра у вас и кто ими управляет:
| Драйвер | Что требует | Когда выбирать |
|---|---|---|
| kernel-модуль | модуль под версию ядра, собирается и грузится на каждой ноде | старые ядра без eBPF; среды, где BPF запрещён политикой |
| eBPF-проба | ядро с включённым BPF; проба скачивается как артефакт | переходный вариант для ядер 4.x |
| modern_ebpf | ядро ≥ 5.8 с BTF; ничего не скачивает и не собирает | managed-кластеры и свежие узлы — разумный дефолт |
Совет практичный: если узлы на ядре 5.8+ — любой managed-кластер моложе пары лет, — ставьте modern_ebpf: ни загрузки артефактов, ни пересборки после обновления ядра. Kernel-модуль остаётся рабочим вариантом для старых железных нод, но требует дисциплины: обновили ядро — пересобрали модуль.
Правила: списки, макросы, условие
Из коробки Falco приходит с ruleset в несколько сотен правил: шелл в контейнере, запись в чувствительные пути, запуск сетевых утилит, поведение криптомайнеров, обращение к API-серверу из пода. Формат — YAML, и он собирается из повторно используемых блоков, как конструктор:
- list — плоский список значений:
shell_binariesс ash, bash, zsh и остальными, - macro — именованный фрагмент условия:
spawned_processзначит «событие execve/execveat»,container— «событие произошло в контейнере», - rule — само правило:
conditionиз макросов и полей,outputсо значениями полей,priorityиtags.
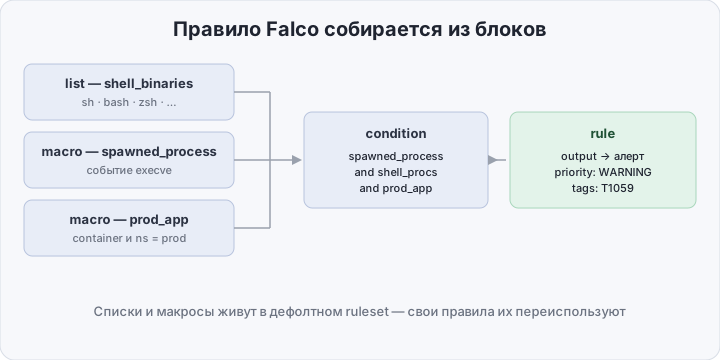
Свои правила кладут отдельным файлом — дефолтный ruleset не трогают, чтобы его можно было обновлять чартом. Два детекта из заготовки: шелл в контейнере, где его не должно быть, и mount хост-директории изнутри контейнера:
# app-runtime-rules.yaml
- macro: prod_app
  condition: container and k8s.ns.name in (prod)

- rule: Interactive Shell in Application Container
  desc: Shell spawned inside a prod app container where no shell should ever run
  condition: >
    spawned_process and shell_procs and prod_app
    and not k8s.pod.name startswith debug
  output: >
    shell in app container (user=%user.name proc=%proc.name
    parent=%proc.pname image=%container.image.repository
    pod=%k8s.pod.name ns=%k8s.ns.name)
  priority: WARNING
  tags: [container, shell, mitre_execution, T1059]

- rule: Container Mounting Host Filesystem
  desc: A mount syscall from inside a container — mounting is the runtime's job, not the workload's
  condition: >
    evt.type = mount and container
    and not proc.name in (runc, crun, dockerd, containerd-shim, kubelet)
  output: >
    mount inside container (user=%user.name proc=%proc.name
    args=%evt.args image=%container.image.repository
    pod=%k8s.pod.name ns=%k8s.ns.name)
  priority: CRITICAL
  tags: [container, filesystem, mitre_privilege_escalation, T1611]
Почему правила написаны именно так:
shell_procsиspawned_process— макросы дефолтного ruleset: свой детект переиспользует чужую работу, а не переписывает список шеллов руками,- неймспейс вынесен в макрос — условие «наши продовые контейнеры» понадобится ещё не раз; поменяете список неймспейсов в одном месте, а не в каждом правиле,
- исключение
debug-подов — привычка инженеров заходить в под отладчиком не должна будить SIEM; исключение — одна строка условия, а не allow-лист на стороне менеджера, - mount-правило фильтрует процессы рантайма:
mount(2)внутри контейнера — нормальная работа runc и containerd-shim, именно они монтируют тома; если mount делает кто-то другой, значит привилегированный контейнер тянет хостовую файловую систему — и приоритет честно CRITICAL, - T1059 и T1611 в тегах — те же техники MITRE ATT&CK for Containers, что мы вешали на правила аудита в части 5: алерты из API и из runtime лягут в одну матрицу.
falcosidekick: шина для алертов
Сам Falco по части вывода аскетичен: файл, stdout, HTTP, gRPC. Расширяет его falcosidekick — лёгкий сервис, который принимает события Falco по HTTP и раздаёт их в несколько десятков выходов: Slack и Teams для людей, Loki и Elasticsearch для хранения, webhook для всего остального. В конвейере он занимает место шины: движок Falco занят фильтрацией и не должен знать, куда летят алерты и что делать при недоступности получателя. Для нашей задачи нужен один выход — syslog на Wazuh; webhook выбирайте, если алерты принимает Wazuh API или любой другой HTTP-коллектор.
Чем Falco дополняет аудит из части 5
Соберём оба механизма рядом — видно, что они не конкурируют, а стыкуются:
| Аудит API (часть 5) | Falco | |
|---|---|---|
| Точка наблюдения | HTTP-запросы к kube-apiserver | syscalls всех контейнеров ноды |
| Отвечает на вопрос | «кто и что попросил у кластера» | «что процесс реально сделал» |
| Типовые детекты | exec, чтение secrets, RBAC-дрейф | шелл в поде, запись в /etc, криптомайнер |
| Слепая зона | процессы после старта пода | RBAC-контекст: кто создал под |
| Где живёт | флаги apiserver + Fluent Bit | DaemonSet в кластере |
| Цена | объём audit-лога | немного CPU и RAM на ноду |
Та же атака глазами связки: аудит фиксирует «dev@company сделал exec в api-7d9f», Falco — «в api-7d9f запустился sh, прочитал /etc/passwd и открыл соединение наружу». Первый говорит, кто вошёл, второй — что сделал вошедший; таймлайн склеивается в Wazuh по имени пода.
Что нужно, чтобы завести Falco и отправить алерты в Wazuh
- кластер Kubernetes с ядрами ≥ 5.8 для modern_ebpf и установленным Helm,
- менеджер Wazuh с syslog-приёмником из части 5 — тем самым
<remote>на 514/tcp сallowed-ipsна сеть подов; ничего нового открывать не нужно, - неймспейс prod с любым приложением, у которого в контейнере не должно быть шелла.
Конфигурация чарта — один values-файл, который включает драйвер, JSON-вывод, наши правила и sidekick:
# values-falco.yaml
driver:
  kind: modern_ebpf

falco:
  json_output: true
  json_include_output_property: true
  time_format_iso_8601: true
  priority: warning        # порог отсечения: notice-шум не отправляем

customRules:
  app-runtime-rules.yaml: |-
    # оба правила из предыдущего раздела — целиком, как есть

falcosidekick:
  enabled: true
  config:
    syslog:
      host: "WAZUH_MANAGER_IP"
      port: "514"
      protocol: "tcp"
Установка:
helm repo add falcosecurity https://falcosecurity.github.io/charts
helm repo update
helm install falco falcosecurity/falco -n falco --create-namespace -f values-falco.yaml
Обвязку для falcosidekick.enabled чарт делает сам: Falco начинает отправлять JSON-события на сервис sidekick, а тот — на ваш syslog. На менеджер событие прилетает в знакомом по части 5 виде — JSON-строкой:
{"hostname":"node-1","output":"shell in app container (user=root proc=sh ...)","priority":"Warning","rule":"Interactive Shell in Application Container","time":"2026-10-12T07:12:44.123456789Z","output_fields":{"container.image.repository":"shop/api","k8s.ns.name":"prod","k8s.pod.name":"api-7d9f-xk2lp","proc.name":"sh","user.name":"root"}}Дальше — знакомая пара декодер и правила, /var/ossec/etc/decoders/local_decoder.xml:
<decoder name="falco">
  <prematch>^.+"priority":"</prematch>
  <plugin_decoder>JSON_Decoder</plugin_decoder>
</decoder>
Prematch цепляется за поле, которого нет ни в аудит-событиях, ни в логах агентов; JSON-движок разворачивает событие, и правилам доступны rule, priority, output и hostname. Правила — в /var/ossec/etc/rules/local_rules.xml, ID продолжают нумерацию части 5:
<group name="falco,runtime,">

  <rule id="100220" level="3">
    <decoded_as>falco</decoded_as>
    <description>falco: $(rule) [$(priority)]</description>
  </rule>

  <rule id="100221" level="12">
    <if_sid>100220</if_sid>
    <field name="rule">^Interactive Shell in Application Container</field>
    <description>falco: shell in application container — $(output)</description>
    <mitre><id>T1059</id></mitre>
  </rule>

  <rule id="100222" level="12">
    <if_sid>100220</if_sid>
    <field name="priority">^(Critical|Alert|Emergency)$</field>
    <description>falco: high-priority runtime event — $(rule)</description>
  </rule>

</group>- базовое правило уровня 3 — все runtime-события попадают в дашборд, дети навешивают конкретику; ровно та же иерархия
if_sid, что мы строили для аудита, - 100221 — точный детект по имени правила Falco:
outputтащит в алерт всю строку с подом и образом, - 100222 — эскалация по приоритету: CRITICAL-события, вроде нашего mount хост-файловой системы, не нуждаются в собственном правиле — приоритет Falco уже несёт семантику.
После правок перезапустите менеджер: systemctl restart wazuh-manager.
Как проверить, что всё работает
Сначала убедитесь, что датчики живы — на каждой ноде под Falco должен отчитаться о загрузке драйвера:
kubectl -n falco get pods -o wide
kubectl -n falco logs -l app.kubernetes.io/name=falco --tail=5
Живая проверка end-to-end — та же, что в части 5, только теперь смотрим runtime: exec шелла в продовый под:
kubectl -n prod exec -it deploy/api -- shВ логах пода Falco должна появиться строка Interactive Shell in Application Container с вашим подом, а на менеджере — алерт:
tail -f /var/ossec/logs/alerts/alerts.json | grep -E '100221|100222'Если в логах Falco событие есть, а в Wazuh нет — разрыв в транспорте: смотрите под falcosidekick (kubectl -n falco logs deploy/falco-falcosidekick) и /var/ossec/logs/ossec.log на ошибки syslog-приёмника. Декодер и правила, как всегда, проверяются офлайн через /var/ossec/bin/wazuh-logtest: вставьте JSON-строку события и убедитесь, что Phase 2 нашла декодер falco, а Phase 3 — правило 100221.
Итог
Falco закрывает последнюю дыру цикла — то, что Wazuh органически не видел: процессы внутри контейнеров. Вместе с агентами на хостах (части 1–4), аудитом control-plane (часть 5) и runtime-детектами получается SIEM, у которого закрыт весь путь атакующего: вход на хост, запрос к API, syscall в ядре. Цена вопроса — DaemonSet на нодах и десяток строк YAML. Ни одной enterprise-лицензии, один дашборд, одни правила, один Active Response на всё.