

Полгода назад мы подняли Backstage за один вечер и получили каталог сервисов. Полгода спустя типичный вопрос от инженеров звучит так: «а зачем мы вообще на него смотрим?». Каталог без scorecard превращается в список ссылок, который открывают один раз при онбординге и больше никогда — и это ровно тот момент, когда platform-команда начинает выглядеть как инфраструктурный сервис на доверии, а не как что-то измеримое.
Содержание
Открыть содержание
- Каталог — это витрина, scorecard — это рычаг
- Что вообще считать метрикой
- TechInsights: open-source alternative Port и Cortex не нужен
- Как это выглядит для команды, а не только для платформы
- Platform NPS: как измерять довольство самой платформой
- Comparison: каталог сам по себе vs каталог со scorecards
- Анти-паттерн: scorecard как дубинка для команд
- Как проверить, что всё работает
- Итог
Каталог — это витрина, scorecard — это рычаг
Backstage, Port и Cortex одинаково хорошо умеют показать список сервисов, их владельцев и ссылки на репозитории. Это полезно, но само по себе не создаёт ни одного стимула что-то улучшать. Каталог отвечает на вопрос «что у нас есть», а руководству и самим командам куда важнее вопрос «что из этого в порядке, а что нет — и по какому конкретно измерению».
Scorecard закрывает именно этот разрыв: это набор количественных проверок, которые прогоняются по каждому сервису в каталоге и превращаются в понятное число или статус — «7 из 10», «green/yellow/red», «покрыто / не покрыто». Разница принципиальна: каталог — это база данных, scorecard — это функция над ней, которая выдаёт сигнал к действию.
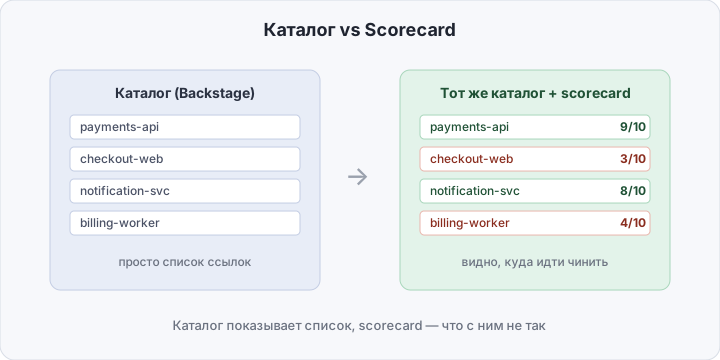
Gartner прогнозирует, что к концу 2026 года 80% крупных инженерных организаций будут иметь отдельную platform-команду. Рост числа таких команд означает и рост числа команд, которым придётся объяснять руководству, что каталог сервисов — это не просто ещё один UI, а часть, за которую стоит платить. Без scorecard это объяснение звучит неубедительно: «у нас есть красивый список» — не аргумент в разговоре про бюджет и headcount.
Что вообще считать метрикой
Не любое число становится полезной метрикой. Хорошая метрика для scorecard — та, у которой есть однозначный источник данных, обновляется автоматически и указывает на конкретное действие, а не просто описывает состояние. Разумный стартовый набор:
- Онколл-нагрузка. Число алертов на сервис за последние 30 дней и доля из них, закрытых без эскалации. Растущая нагрузка на один сервис — сигнал, что в него пора вложиться, а не просто терпеть.
- Свежесть SBOM. Когда последний раз генерировался Software Bill of Materials и не просрочен ли он относительно последнего релиза. Устаревший SBOM означает, что при следующем Log4Shell никто не сможет быстро сказать, задет сервис или нет.
- Покрытие тестами. Не абсолютное число (100% покрытия — не цель сама по себе), а тренд: падает или растёт относительно прошлого квартала.
- Staleness документации. Дата последнего изменения README и TechDocs относительно даты последнего деплоя. Если сервис деплоился десять раз, а документация не менялась ни разу, это почти гарантированно означает, что она врёт.
- Наличие build provenance. Бинарный признак: подписан ли артефакт сервиса SLSA-провенансом или нет — прошёл ли он через доверенный CI, а не собран кем-то локально и просто запушен в registry.
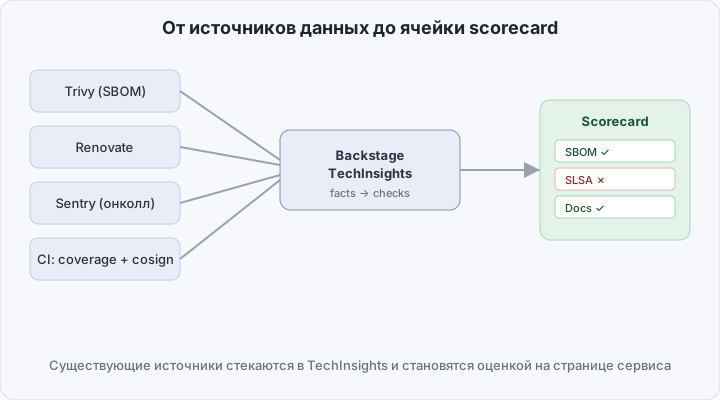
Ключевое свойство этого набора — все пять метрик уже собираются существующими инструментами. Онколл — данными PagerDuty/Sentry, SBOM и provenance — Trivy и подписанными артефактами CI, покрытие тестами — отчётом самого пайплайна, staleness документации — git-историей. Scorecard не создаёт новые данные, он агрегирует то, что уже есть, в одном месте.
TechInsights: open-source alternative Port и Cortex не нужен
Port и Cortex продают scorecards как готовую фичу коммерческого IDP: подключаете источники через их коннекторы, получаете дашборд. Для команды, которая уже подняла Backstage, платить за отдельный продукт ради одной фичи избыточно — у Backstage есть свой плагин TechInsights, который делает то же самое поверх уже настроенного каталога.
TechInsights работает через две сущности: факты (facts) — сырые данные, которые собирает FactRetriever по расписанию, и проверки (checks) — условия над этими фактами, которые дают true/false или числовую оценку. Scorecard — это просто именованная группа проверок, привязанная к сущности каталога.
# app-config.production.yaml
techInsights:
  factRetrievers:
    slsaProvenanceFactRetriever:
      cadence: "PT1H"
      schedule:
        frequency: { hours: 1 }
        timeout: { minutes: 5 }

  scorecards:
    - id: supply-chain
      title: "Supply chain hygiene"
      description: "Есть ли у сервиса подписанный build provenance"
      checks:
        - id: has-slsa-provenance
          type: boolean
          factRef:
            - fact: hasSlsaProvenance
              schema: slsaProvenanceFactRetriever
          rule:
            operator: equals
            value: true
FactRetriever для hasSlsaProvenance — это TypeScript-модуль, который на каждой итерации ходит в registry, ищет attestation рядом с образом (тот же cosign verify-attestation, что уже используется в пайплайне) и пишет true/false в базу TechInsights для каждого сервиса из каталога. Дальше проверка has-slsa-provenance просто читает этот факт и красит ячейку scorecard в зелёный или красный.
Как это выглядит для команды, а не только для платформы
Отдельная страница со scorecard-дашбордом полезна руководству, но для инженера, который открывает страницу своего сервиса в Backstage, ценность в другом — в виджете EntityScorecardContent, встроенном прямо в тот же таб, где он смотрит на CI-статус и линки на дашборды. Он не идёт куда-то отдельно проверять «здоровье» сервиса — оно уже написано рядом с остальной информацией, которую он и так открывал.
Это работает и в обратную сторону: если scorecard живёт только на отдельной странице для менеджеров, инженеры её просто не увидят и не будут реагировать на красные ячейки. Встраивание в ту же страницу, где команда и так работает — не косметика, а условие, без которого метрика не влияет на поведение.
Platform NPS: как измерять довольство самой платформой
Технические scorecards отвечают на вопрос «в порядке ли сервис». Отдельный и не менее важный вопрос — «считают ли инженеры, что каталог и golden paths вообще помогают им». Это измеряется классическим Net Promoter Score, адаптированным под platform engineering: раз в квартал короткий опрос из одного вопроса — «насколько вероятно, что вы порекомендуете внутреннюю платформу коллеге, от 0 до 10» — плюс опциональное поле для комментария.
Ориентиры по индустрии: platform NPS ниже 0 означает, что платформа скорее мешает, чем помогает, и это стоит разбирать в первую очередь, а не добавлять новые фичи в каталог. NPS в диапазоне 0–30 — типичное состояние для платформы, которая уже приносит пользу, но не является предметом гордости команды. Выше 30 — редкость даже для зрелых platform-организаций, и стремиться туда стоит не ради самого числа, а потому что за ним обычно стоит реально низкий onboarding time и малое число тикетов в platform-команду.
Важная деталь: NPS нужно собирать анонимно и не привязывать к конкретным командам-респондентам. Как только опрос становится атрибутируемым, ответы начинают отражать не мнение о платформе, а страх испортить отношения с её владельцами.
Comparison: каталог сам по себе vs каталог со scorecards
| Каталог без scorecard | Каталог со scorecard | |
|---|---|---|
| Что видит инженер | Список сервисов и ссылки | Список + оценка по каждому измерению |
| Как узнать, что сервис нужно чинить | Случайно, через инцидент | Красная ячейка появляется до инцидента |
| Аргумент для бюджета platform-команды | «У нас красивый UI» | «Х сервисов подняли SLSA с 40% до 90% за квартал» |
| Источник правды про качество | Мнение тимлида | Агрегация данных из Trivy/Renovate/Sentry/CI |
| Довольство платформой | Не измеряется | Platform NPS раз в квартал |
Анти-паттерн: scorecard как дубинка для команд
Самый быстрый способ убить пользу от scorecards — превратить их в KPI, по которому оценивают команды на перформанс-ревью. Как только красная ячейка начинает угрожать премии, происходит ровно то, что происходит с любой метрикой, ставшей целью: команды начинают оптимизировать под саму метрику, а не под то, что она должна была измерять. Покрытие тестами дотягивают бессмысленными assert-без-логики тестами, документацию правят одной строкой раз в квартал ради даты последнего коммита, SLSA-provenance добавляют формально, не проверяя, что подпись реально валидна.
Правильное применение scorecard — это приоритизация платформенной работы, а не наказание продуктовых команд. Красная ячейка «нет SLSA provenance» у пятнадцати сервисов из двадцати — это не пятнадцать провинившихся команд, это сигнал platform-команде, что нужно сделать подключение provenance частью golden path по умолчанию, а не документацией, которую надо читать и применять руками. Scorecard считает не то, кто виноват, а то, куда вложить следующий спринт platform-инженеров.
Как проверить, что всё работает
После того как FactRetriever и scorecard описаны в app-config.production.yaml и Backstage перезапущен, есть три быстрые проверки. Первая — факт действительно собирается: curl -s localhost:7007/api/tech-insights/facts/slsaProvenanceFactRetriever/latest | jq должен вернуть непустой массив с полями hasSlsaProvenance для сервисов из каталога, а не ошибку 404. Вторая — проверка считается: curl -s localhost:7007/api/tech-insights/checks/has-slsa-provenance/result?entity=component:default/my-service | jq .result должен вернуть true или false, а не null. Третья — виджет реально виден: открыть страницу любого сервиса в UI и убедиться, что EntityScorecardContent отрисовал ячейку с цветом, а не пустой блок с ошибкой в консоли браузера.
Итог
Каталог сервисов без scorecard — это список ссылок, которым интересуются один раз при онбординге. Scorecard превращает тот же каталог в измеримый актив: конкретные числа по security, reliability и документации, которые тянутся из уже подключённых Trivy, Renovate и Sentry через открытый плагин TechInsights, без необходимости платить за коммерческий Port или Cortex ради одной фичи. Цена — несколько вечеров на FactRetriever-ы и дисциплина не превращать зелёные ячейки в KPI для перформанс-ревью. Выигрыш — platform-команда, которая может показать руководству не «у нас есть каталог», а «вот на сколько процентов вырос supply chain hygiene за квартал».