

Кластер, к которому снаружи не подключиться, — это не сломанный кластер, а закрытый по построению: ни одного LoadBalancer, ни одного ingress, API server слушает только внутренний интерфейс. Годами упиралось это в последнюю милю: как пустить туда команду и CI, не открыв дверь в интернет. Tailscale Kubernetes Operator закрывает её штатно — сервисы публикуются прямо в tailnet, а Connector CRD заворачивает весь cluster CIDR в subnet router, и обычный ClusterIP Grafana становится адресом в вашей mesh-сети.
Почему сейчас: документация оператора и Connector CRD — subnet router и exit node в одном ресурсе — основательно обновилась в июне 2026, деплой subnet router стал официально рекомендуемым путём доступа к кластеру, а ProxyGroup и API server proxy закрыли оставшиеся дыры — отказоустойчивость и kubectl без публичного API.
Содержание
Открыть содержание
Кластер без публичных IP: что вместо ingress
Что вообще значит «приватный кластер» на практике. У управляемых — private node groups и control plane с приватным endpoint, доступным только из VPC. У кластера на своих VM — ноды без внешних адресов и kube-apiserver, слушающий внутренний интерфейс. В обоих случаях внутри всё работает: поды общаются, ClusterIP раздаются, CI-runner в той же сети деплоит без вопросов. Проблема начинается ровно в тот момент, когда разработчик садится за ноутбук дома.
Способы открывать приватное давно устоялись, и у каждого есть цена. VPN-сервер или bastion рядом с кластером — ещё одна машина, которую нужно патчить, мониторить и которая является единой точкой отказа. Ingress с allowlist по офисным IP — почти бесплатно, но офисные адреса протухают при первой же смене провайдера, и LB :443 всё равно торчит наружу. Cloudflare Tunnel — мы про него писали: исходящий туннель без открытых портов, но каждый сервис живёт за публичным hostname и ходит через чужую сеть. NetBird — мы разбирали его тоже: self-hosted WireGuard-mesh с политиками, но кластер в неё всё равно надо как-то заводить — вручную, отдельным контейнером.
Общее у всех вариантов: что-то публичное остаётся, и это что-то сканируется ботами круглосуточно.
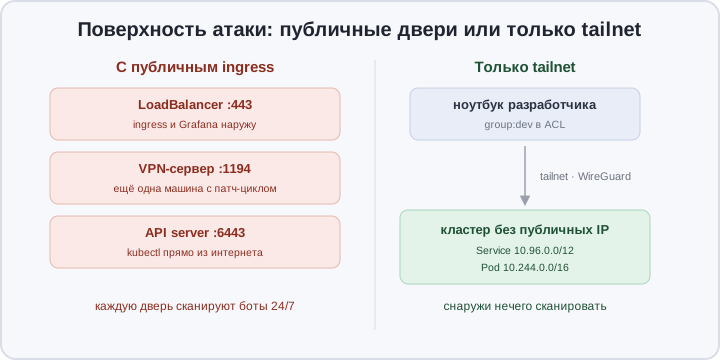
Нулевая поверхность атаки — это не «очень хорошо защищённая дверь», а отсутствие двери: снаружи нечего сканировать, нечего брутфорсить, нечему получать CVE. Кластер с private node groups и без единого LoadBalancer даёт именно это — до тех пор, пока внутри tailnet всем хватает.
Как оператор открывает кластер в tailnet
Оператор ставится helm-чартом и приносит с собой CRD. С точки зрения сети он умеет три вещи, и для приватного кластера нужны первые две.
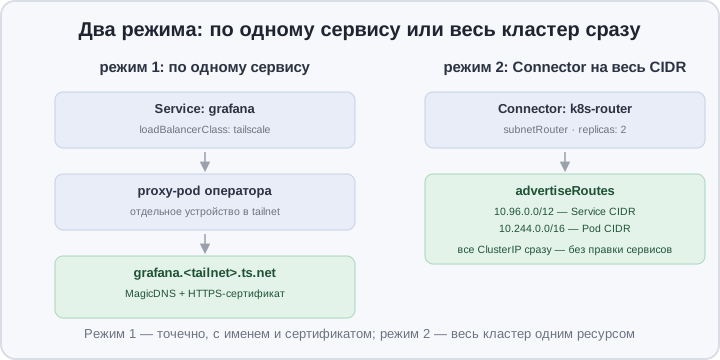
По одному сервису. Сервису ставится loadBalancerClass: tailscale (или классическая аннотация tailscale.com/expose: "true" с tailscale.com/tailnet-hostname: grafana) — оператор поднимает proxy-pod, в tailnet появляется отдельное устройство с MagicDNS-именем grafana.<tailnet>.ts.net и настоящим HTTPS-сертификатом. Тот же результат даёт Ingress с ingressClassName: tailscale. Точечный режим: одно правило ACL на один сервис.
Сразу весь кластер. Ресурс Connector поднимает subnet router на выбранные CIDR — service и pod. Один манифест, и каждый ClusterIP кластера доступен из tailnet без правки самих сервисов. replicas: 2 даёт отказоустойчивость, тот же ресурс умеет быть exit node.
kubectl без публичного API. Если при установке включить apiServerProxyConfig.mode="true", команда tailscale configure kubeconfig допишет в kubeconfig контекст через tailnet: kubectl ходит в API server напрямую, а RBAC работает от Tailscale-идентичности — прокси прокладывает её в заголовки запроса.
Есть и обратное направление — из кластера наружу: Egress-сервисы (ExternalName с аннотацией tailscale.com/tailnet-fqdn) пускают поды в tailnet-ресурсы, а ProxyClass с exitNodeIP заворачивает исходящий трафик прокси через офисный exit node — удобно для легаси-сервисов, завязанных на офисный IP-адрес.
Две вещи, которые стоит знать про этот зоопарк. Funnel: аннотация tailscale.com/funnel: "true" на том же ingress публикует сервис публично — через Tailscale, с TLS, без единого LoadBalancer в кластере; для «покажи демо заказчику» это единственная легитимная дверь наружу, и закрывается она удалением аннотации. ProxyGroup: группа proxy-подов с одним MagicDNS-именем для пер-сервисного режима и мультикластера — реплики за одним именем, мёртвые выкидываются автоматически.
Сравнение в одной таблице
| VPN-сервер | NetBird | Cloudflare Tunnel | Tailscale-оператор | |
|---|---|---|---|---|
| Публичные endpoint’ы | порт VPN наружу | нет | нет портов, но hostname публичный | нет вообще |
| Control plane | ваш сервер | ваш self-host или их cloud | Cloudflare | Tailscale (управляемый) |
| Цена | VM + ваше время | OSS, бесплатно | щедрый free-план | бесплатно до 3 пользователей |
| Падение control plane | VPN лёг — все офлайн | новые пиры не подключатся | нет Cloudflare — нет доступа | живые туннели работают, новые — нет |
| Что получает команда | всю сеть сегментом | mesh + политики | веб-сервисы по hostname | ClusterIP, поды, kubectl, MagicDNS |
Ключевая разница с двумя нашими прошлыми вариантами: NetBird и Cloudflare Tunnel решают «как добраться до кластера», а оператор решает «как выдать кластер целиком» — включая pod-сеть и API server, без отдельной VM и без публичных hostname даже для аутентификации.
Что нужно, чтобы поднять приватный доступ
Предусловия: кластер с известными CIDR (service и pod — смотрите флаг --service-cluster-ip-range у kube-apiserver и конфигурацию CNI), tailnet с группами из IdP (дальше — group:dev), helm 3.
1. ACL: теги и автосогласование маршрутов. Оператор не стартует без тегов, поэтому ACL правим первым делом:
"tagOwners": {
  "tag:k8s-operator": ["group:admin"],
  "tag:k8s-router":   ["tag:k8s-operator"]
},
"autoApprovers": {
  "routes": {
    "10.96.0.0/12":  ["tag:k8s-router"],
    "10.244.0.0/16": ["tag:k8s-router"]
  }
}
autoApprovers — чтобы subnet-маршруты соглашались сами, без ручного клика в Machines за каждую реплику.
2. OAuth-клиент. В админке: Trust credentials → + Credential. Скоупы: Services (Read/Write), Devices — Core (Read/Write), Keys — Auth Keys (Read/Write); тег — tag:k8s-operator. Сохраните Client ID и Client Secret.
3. Оператор. Установка одной командой:
helm repo add tailscale https://charts.tailscale.com
helm install tailscale-operator tailscale/tailscale-operator \
  -n tailscale --create-namespace \
  --set oauth.clientId=<CLIENT_ID> \
  --set oauth.clientSecret=<CLIENT_SECRET> \
  --set-string apiServerProxyConfig.mode="true"
4. Connector. Тот самый subnet router на весь кластер:
apiVersion: tailscale.com/v1alpha1
kind: Connector
metadata:
  name: k8s-router
spec:
  hostnamePrefix: k8s-router
  tags: ["tag:k8s-router"]
  replicas: 2
  subnetRouter:
    advertiseRoutes:
      - "10.96.0.0/12"    # Service CIDR — ClusterIP
      - "10.244.0.0/16"   # Pod CIDR
5. Доступ команде. Грант на dev-группу — и всё, без VPN-сервера:
"grants": [{
  "action": "accept",
  "src":    ["group:dev"],
  "dst":    ["10.96.0.0/12:*", "10.244.0.0/16:*"]
}]
Гранулярность — на ваш выбор: разные команды — разными диапазонами и правилами, а точечный доступ к одному сервису — per-service режимом с отдельным тегом на сервис.
Как проверить
Сначала сам роутер и маршруты:
kubectl get connector k8s-router
# NAME         SUBNETROUTES                 ISEXITNODE   STATUS
# k8s-router   10.96.0.0/12,10.244.0.0/16   false        ConnectorCreated

tailscale status | grep k8s-router
tailscale ping k8s-router     # прямой туннель до роутера
Дальше с ноутбука разработчика — Grafana по ClusterIP без единого публичного endpoint:
kubectl -n monitoring get svc grafana \
  -o jsonpath='{.spec.clusterIP}{"\n"}'    # скажем, 10.96.42.17
curl -I http://10.96.42.17:3000            # HTTP/1.1 200 OK
И kubectl через tailnet:
tailscale configure kubeconfig
kubectl --context=<tailnet-контекст> get ns
Финальная проверка — взгляд атакующего: с машины вне tailnet nmap -Pn <node-ip> должен показывать только SSH ноды — никакого :6443, никакого :443 от кластерных сервисов.
Грабли
- Маршрут висит непроверенным. Тег в Connector не совпал с тегом в
autoApproversили CIDR опечатан — маршрут ждёт ручного одобрения в Machines, а вы думаете, что всё работает. Всегда сверяйте колонку SUBNETROUTES вkubectl get connector. - Грант шире, чем нужно. Доступ на весь service CIDR — это доступ к каждому сервису кластера, включая продовые БД. Внутренние границы — разными грантами на разные диапазоны; пер-сервисный доступ — режимом аннотаций.
- Имени нет, есть IP. Subnet router даёт адреса, но не кластерный DNS:
grafana.monitoring.svc.cluster.localс ноутбука не резолвится. Нужны имена — добавьте per-service режим, там есть MagicDNS. - Весь трафик через роутер. Пакеты до ClusterIP идут через поды Connector’а — это не P2P. Ставьте
replicas: 2и не скупитесь на реквесты; для больших объёмов точечный режим эффективнее, его proxy-поды живут рядом с сервисами. - Перекрывающиеся подсети. Если в tailnet уже есть 10.96.0.0/… из офисной сети, IPv4-маршруты конфликтуют — у Tailscale для этого есть 4via6-маршруты, они адресуют подсети в IPv6-пространстве.
Итог
Для внутреннего продукта кластер без публичных IP — не экзотика, а самый короткий путь к нулевой поверхности атаки: нечего сканировать, нечему получать CVE, нечего прятать за WAF. Плата — зависимость доступа от tailnet и дисциплина ACL вместо allowlist’ов; отдача — kubectl и Grafana с любого устройства команды, CI-runner в той же сети и ноль публичных hostname. Оператор и один Connector поднимаются за вечер — а следующим шагом тем же оператором закрывается и egress, через офисный exit node.