Prometheus отличный, пока метрики помещаются в локальный диск: две недели retention, один StatefulSet, ноль внешних зависимостей. Боль начинается с вопроса «а что случилось месяц назад?» — и к Prometheus пристраивается Thanos: sidecar, store gateway, compactor, query. VictoriaMetrics закрывает тот же сценарий одним процессом, а в июле 2026 у неё вышла LTS-линейка v1.148.0 с фиксами на год вперёд — повод честно разложить, до какого размера метрик это экономия, а где самообман.
Содержание
Открыть содержание
- Чем заканчивается «просто Prometheus»
- Что меняет VictoriaMetrics
- Порог применимости: где single, а где cluster
- Prometheus+Thanos против VM single
- Два сценария перехода
- Что нужно, чтобы собрать стек в одном namespace
- Кардинальность: главный враг бюджета
- Цифры: RAM и диск
- Как проверить, что всё работает
- Итог
Чем заканчивается «просто Prometheus»
Локальный TSDB хранит блоки на PV: год retention — терабайтный диск и рестарты с холодным кэшем. HA — два Prometheus и дедуп на чтении.
Стандартный ответ — Thanos. Для терабайтов архитектура честная, но посчитайте компоненты: sidecar рядом с каждым Prometheus, store gateway (индекс по старым блокам), compactor (компакция и downsampling), query (склейка свежего и старого). Четыре-пять деплойментов с версиями и апгрейдами, плюс бакет в S3.
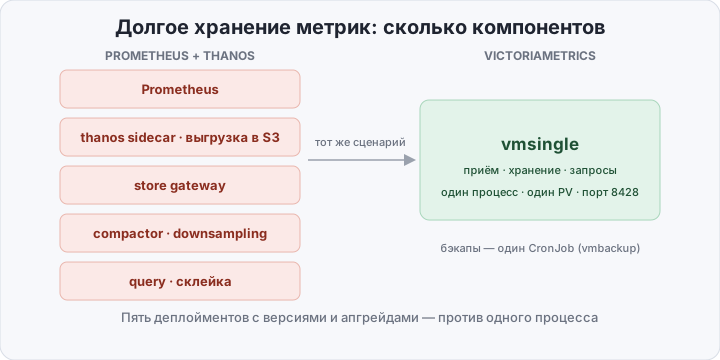
На малом кластере каждый почти пустой: store на гигабайты, query, который никто не грузит. Вы обслуживаете топологию под терабайты ради десятков гигабайт.
Что меняет VictoriaMetrics
- один бинарь — приём, хранение и запросы в одном процессе: один PV, один порт
:8428; - совместимость — remote_write, Prometheus HTTP API, Grafana-дашборды как есть; MetricsQL — практическое надмножество PromQL;
- сжатие — дельта-кодирование по значениям и label-сетам: на тех же данных диск меньше в разы;
- retention — флаг, а не архитектура —
-retentionPeriodменяется рестартом, без компакции и S3-политик; - одна версия на всё — vmagent, vmalert и vmbackup выходят одним релизом с vmsingle: апгрейд — смена тега.
Что из экосистемы реально нужно на малом масштабе:
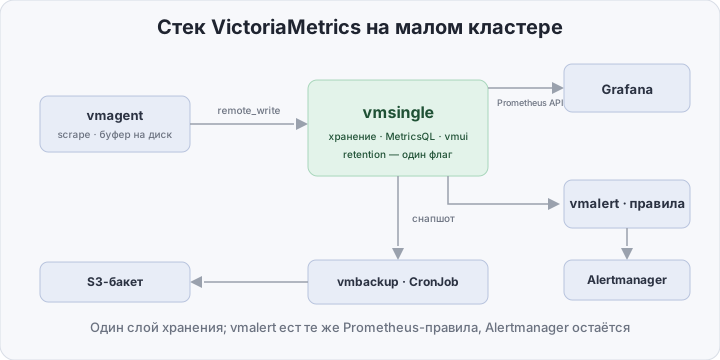
- vmagent — scrape и доставка: service discovery как у Prometheus, relabeling, буфер на диск. Нужен при полной замене;
- vmalert — правила и алерты: ест те же Prometheus-правила; Alertmanager остаётся, его VM не заменяет;
- vmbackup — снапшоты в S3 по расписанию + vmrestore для проверки восстановления; инкрементальные бэкапы автоматически — vmbackupmanager (enterprise);
- vmgateway — auth и rate limiting перед VM: enterprise-компонент, на малом масштабе не нужен.
Порог применимости: где single, а где cluster
Оперируйте тремя числами: active time series (уникальных label-сетов), rate приёма (samples/sec) и churn (рождается и умирает серий в час).
- до ~100k — single без раздумий: сотни МБ RAM, любой узел;
- ~100k–1M — зона комфорта single: 1–4 ГБ RAM, один PV; следите за RAM и io, архитектура не меняется;
- >1M, мультитенантность или горизонтальное масштабирование — cluster-режим: vmstorage (данные), vminsert (запись), vmselect (чтение).
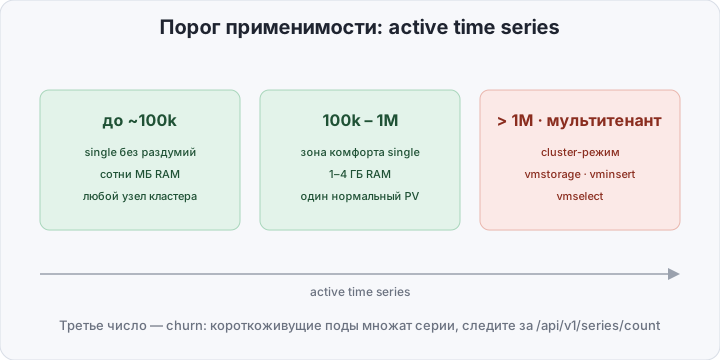
Оговорка про HA: single — один процесс. Бэкапы через vmbackup обязательны, а живая отказоустойчивость приёма — довод в сторону cluster-режима, а не «второго vmsingle». Мягчает буфер vmagent: пока стор недоступен, метрики копятся на диске агента.
Prometheus+Thanos против VM single
| Prometheus + Thanos | VM single | |
|---|---|---|
| Компоненты хранения | 4–5 деплойментов | 1 (+CronJob бэкапа) |
| Хранилище | S3 + локальный TSDB | PV + S3 для бэкапов |
| RAM стека | ~5–6 ГБ | ~1–1.5 ГБ |
| Диск на те же данные | 1× | обычно 2–4× меньше |
| Запросы в глубину | query + store, с задержкой | один endpoint |
| Смена retention | компакция, downsampling | -retentionPeriod + рестарт |
| Апгрейд | согласованно 4 компонента | один тег на стек |
| HA приёма | два Prometheus + дедуп | cluster-режим |
| Правила и алерты | Prometheus rules | vmalert + Alertmanager, те же правила |
| Язык запросов | PromQL | MetricsQL (надмножество) |
Два сценария перехода
Remote-write из существующего Prometheus. Минимальный риск: добавляете remote_write на http://vmsingle:8428/api/v1/write, укорачиваете локальный retention, правила переносите в vmalert по мере готовности. Откат — удаление одной строки. Историю старше retention перенесёт vmctl prometheus (импорт TSDB-снапшотов).
Полная замена. vmagent забирает scrape (те же kubernetes_sd-роли и relabel-конфиги), Prometheus удаляется. Минус целый стек и большая часть RAM мониторинга; цена — перенос правил. Этот сценарий и разворачиваем.
Что нужно, чтобы собрать стек в одном namespace
Весь стек — в namespace monitoring, на LTS v1.148.0 (фиксы до лета 2027): vmagent пишет в vmsingle, vmalert гоняет правила в Alertmanager, vmbackup раз в 6 часов снимает снапшот в S3, Grafana читает через один datasource.
1. Хранилище: vmsingle. Deployment с PVC и Service:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vmsingle
  namespace: monitoring
spec:
  replicas: 1
  selector: { matchLabels: { app: vmsingle } }
  template:
    metadata: { labels: { app: vmsingle } }
    spec:
      containers:
        - name: vmsingle
          image: victoriametrics/victoria-metrics:v1.148.0
          args:
            - -storageDataPath=/storage
            - -retentionPeriod=12m      # месяцы
            - -search.maxUniqueTimeseries=500000   # выше вашего числа серий
          ports: [{ containerPort: 8428 }]
          volumeMounts: [{ name: data, mountPath: /storage }]
      volumes:
        - name: data
          persistentVolumeClaim: { claimName: vmsingle-data }
---
apiVersion: v1
kind: Service
metadata:
  name: vmsingle
  namespace: monitoring
spec:
  selector: { app: vmsingle }
  ports: [{ port: 8428 }]
2. Сборщик: vmagent. Конфиг скрейпа — как у Prometheus:
apiVersion: v1
kind: ConfigMap
metadata:
  name: vmagent-config
  namespace: monitoring
data:
  scrape.yml: |
    global:
      scrape_interval: 30s
    scrape_configs:
      - job_name: kubernetes-pods
        kubernetes_sd_configs:
          - role: pod
        relabel_configs:
          - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
            action: keep
            regex: "true"
          - source_labels: [__address__, __meta_kubernetes_pod_annotation_prometheus_io_port]
            action: replace
            regex: ([^:]+)(?::\d+)?;(\d+)
            replacement: $1:$2
            target_label: __address__
      # ноды — role: node через apiserver-proxy, конфиг один в один Prometheus
Арги агента — здесь же защита от взрыва кардинальности:
# фрагмент Deployment vmagent
image: victoriametrics/vmagent:v1.148.0
args:
  - -promscrape.config=/config/scrape.yml
  - -remoteWrite.url=http://vmsingle:8428/api/v1/write
  - -remoteWrite.tmpDataPath=/buffer      # буфер на диск
  - -remoteWrite.maxHourlySeries=300000   # кап новых серий в час
  - -remoteWrite.maxDailySeries=1000000   # и в сутки — от кривого релиза
3. Правила: vmalert. Правила из kube-prometheus-stack переезжают без правок; пример:
apiVersion: v1
kind: ConfigMap
metadata:
  name: vmalert-rules
  namespace: monitoring
data:
  rules.yaml: |
    groups:
      - name: k8s
        rules:
          - alert: PodRestartLoop
            expr: increase(kube_pod_container_status_restarts_total[15m]) > 3
            for: 5m
            labels: { severity: warning }
# фрагмент Deployment vmalert
image: victoriametrics/vmalert:v1.148.0
args:
- -datasource.url=http://vmsingle:8428
- -remoteWrite.url=http://vmsingle:8428 # recording rules в VM
- -remoteRead.url=http://vmsingle:8428 # состояние алертов
- -notifier.url=http://alertmanager:9093 # Alertmanager ставится рядом
- -rule=/config/*.yaml4. Бэкапы: vmbackup по CronJob. Снапшот создаётся на стороне vmsingle:
apiVersion: batch/v1
kind: CronJob
metadata:
  name: vmbackup
  namespace: monitoring
spec:
  schedule: "0 */6 * * *"
  jobTemplate:
    spec:
      template:
        spec:
          restartPolicy: OnFailure
          containers:
            - name: vmbackup
              image: victoriametrics/vmbackup:v1.148.0
              args:
                - -snapshot.createURL=http://vmsingle:8428/snapshot/create
                - -dst=s3://metrics-backup/vmsingle
                - -storageDataPath=/storage
                - -s3.endpoint=s3.eu-central-1.amazonaws.com
              volumeMounts: [{ name: data, mountPath: /storage }]
          volumes:
            - name: data
              persistentVolumeClaim: { claimName: vmsingle-data }
Ключи S3 — переменными окружения из Secret (AWS_ACCESS_KEY_ID/AWS_SECRET_ACCESS_KEY).
5. Grafana. Datasource prometheus — API совместим:
apiVersion: v1
kind: ConfigMap
metadata:
  name: grafana-datasources
  namespace: monitoring
data:
  vm.yaml: |
    apiVersion: 1
    datasources:
      - name: VictoriaMetrics
        type: prometheus
        url: http://vmsingle:8428
        isDefault: true
Кардинальность: главный враг бюджета
Кардинальность — число уникальных label-сетов. Каждый новый под и endpoint его множит, а один кривой лейбл (user_id, request_id) превращает 100k серий в 10M. Виновников находят двумя запросами:
topk(10, count({__name__=~".+"}) by (__name__))
topk(10, count by (pod) ({__name__=~".+"}))
Лечение — по нарастающей:
- drop на входе —
metric_relabel_configsв vmagent: runtime-болтовняgo_*и дубли kubelet не должны доезжать до стора; - labeldrop — резать чанжливые лейблы (
pod,container_id), где они не нужны для диагностики; - streamAggr в vmagent — сводить чаттивые метрики до записи, а не после;
- капы на входе —
maxHourlySeries/maxDailySeries: при превышении новые серии дропаются с ошибкой в логах. Это защита от кривого релиза, а не замена гигиене — легитимный рост она тоже порежет, поэтому число серий (GET /api/v1/series/count) держите на дашборде.
Цифры: RAM и диск
Типовой малый prod: три ноды, ~50 подов, kube-prometheus-stack с парой экспортёров — порядка 150k активных серий при интервале 30s. Порядок величин:
- Prometheus: 2–3 ГБ RAM и 25–35 ГБ диска на 90 дней;
- VM single на тех же данных: 0.5–1 ГБ RAM и 8–12 ГБ диска — сжатие label-сетов даёт обычно 2–4×, до 7× на повторяющихся значениях;
- Thanos сверху — ещё 1.5–2 ГБ RAM на sidecar/store/compactor/query плюс компакция, downsampling и lifecycle в S3;
- churn бьёт по обоим, но VM переносит мягче: новая серия в head-блоке Prometheus дороже, чем в ingestion-буфере VM.
Итого — втрое меньше RAM на стек и вдвое-вчетверо меньше диска. Экономия не в лицензиях (всё нужное open source), а в операционке: один объект для обновления вместо пяти.
Как проверить, что всё работает
kubectl -n monitoring get pods
curl -s http://vmsingle.monitoring:8428/health
curl -s http://vmsingle.monitoring:8428/api/v1/series/count- vmui —
kubectl -n monitoring port-forward svc/vmsingle 8428:8428, открывайтеhttp://localhost:8428/vmui: запросupиtopkпо кардинальности; - Grafana — дашборды из kube-prometheus-stack работают без правок, меняется только datasource;
- бэкапы — после первого запуска CronJob проверьте бакет и восстановление:
vmrestoreв scratch-PVC и старт vmsingle на нём. Непроверенный бэкап — не бэкап.
Итог
До ~миллиона активных time series VictoriaMetrics single-binary — самый дешёвый по эксплуатации способ хранить метрики долго: один процесс, один PV, один CronJob бэкапа, в разы меньше RAM и диска, чем у Prometheus+Thanos на тех же данных. Thanos оправдан, когда кластеров много, тенантов больше одного и метрики измеряются терабайтами — там его топология необходимость, а не избыточность. Линия раздела измеримая: active time series. А чтобы рядом с метриками жили логи и трейсы — минимальный OpenTelemetry Collector мы разбирали отдельно.