Годами GPU в Kubernetes выделялись по одному числу: nvidia.com/gpu: 1 в resources.limits — и агент на ноде отдавал поду «какой попало» ускоритель. В Kubernetes 1.34 Dynamic Resource Allocation (DRA) вышел в GA, в 1.35+ фича-гейт закреплён навсегда, а NVIDIA перевела свой device plugin в maintenance mode: новые возможности появляются только в DRA-драйвере. Разбираем, как теперь правильно просить GPU — по атрибутам («память ≥ 16 ГБ»), а не по счётчику, и что сломается при переезде.
Содержание
Открыть содержание
- Device plugins: почему счётчик — тупик
- Три объекта DRA: ResourceSlice, ResourceClaim, DeviceClass
- Pod с ResourceClaim: как теперь просить GPU
- Что нужно, чтобы перевести кластер на DRA
- DRA против device plugins
- Что ломается при миграции
- Когда DRA реально даёт выигрыш
- Как проверить, что всё работает
- Итог
Device plugins: почему счётчик — тупик
Device Plugin API появился в 2017-м, когда «GPU в поде» означало «один целый ускоритель». Схема простая: демон на ноде через gRPC-сокет сообщает kubelet список карт, kubelet публикует их как extended resource nvidia.com/gpu, а планировщик видит число — и только число. Про устройства «знает» только агент на ноде: он же монтирует их в контейнер — через переменные вроде NVIDIA_VISIBLE_DEVICES и хуки container toolkit. В API кластера об ускорителях нет ни объекта, ни атрибутов — спросить не у чего: kubectl get по GPU просто нечего вернуть.
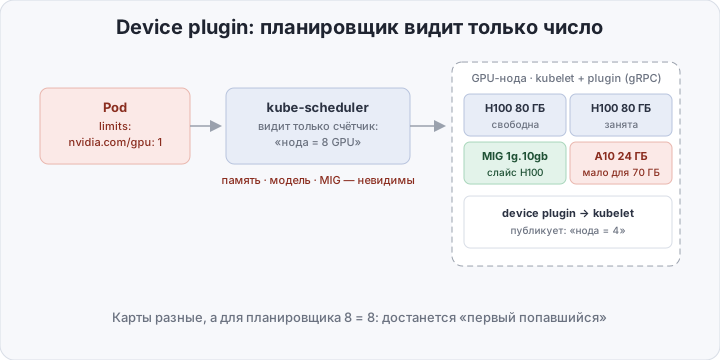
Проблемы начинаются там, где GPU перестают быть одинаковыми:
- MIG — одна H100 режется на слайсы 1g.10gb/2g.20gb; чтобы планировщик узнал о новой разметке, её надо пере-публиковать, и между репартиционированием и обновлением счётчика живут классические гонки;
- time-slicing — несколько подов на одной карте выглядят для kubelet как N «независимых устройств»: планировщик резервирует по 100% каждому, реальный оверсабскрипшн невидим;
- фрагментация — агент раздаёт устройства в порядке индексов, «сверху вниз»: нода считается занятой, когда кончается счётчик, хотя разные карты простаивают вразнобой;
- атрибуты — объём памяти, модель, версия драйвера. Поду с моделью на 70 ГБ всё равно на «единицу GPU»: ему нужна карта с 80 ГБ, а достаётся 16-гигабайтная — отказ приходит уже в рантайме, CUDA OOM, при том что «правильные» карты стоят свободными.
Extended resource не умеет выражать ничего кроме целого числа — это архитектурный потолок API, а не баг, который починят.
Три объекта DRA: ResourceSlice, ResourceClaim, DeviceClass
DRA (API-группа resource.k8s.io/v1) переворачивает модель: вместо счётчика на ноде — инвентарь с атрибутами в API кластера, по которому планирует сам kube-scheduler.
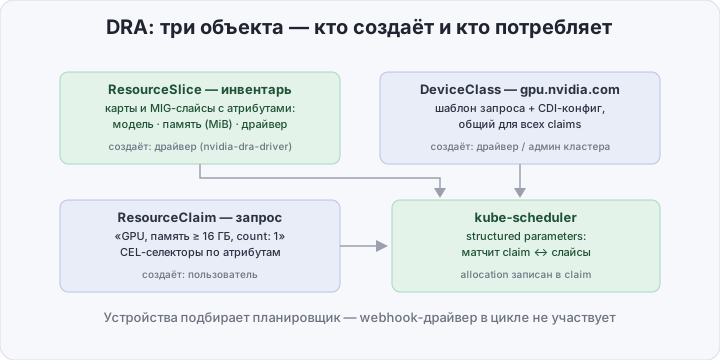
- ResourceSlice — создаёт драйвер (у NVIDIA — nvidia-dra-driver). Это каталог устройств: каждая карта или MIG-слайс — устройство с атрибутами (модель, память в MiB, версия драйвера). Несколько слайсов на кластер — норма, инвентарь атомарно обновляется;
- DeviceClass — создаёт драйвер или админ кластера. Шаблон запроса: какие устройства подходят под имя
gpu.nvidia.com, плюс конфигурация, общая для всех claims (например, CDI-правки контейнера); - ResourceClaim — создаёт пользователь. Внятное ТЗ: «одно устройство из класса gpu.nvidia.com с памятью ≥ 16 000 MiB». Планировщик матчит claim против слайсов и записывает в него решение: какие именно устройства на какой ноде.
Ключевое отличие от ранних прототипов DRA: решения принимает kube-scheduler по структурированным параметрам, без синхронных вызовов внешнего webhook-драйвера — именно из-за них GA и задержался. DRA-драйвер в планировании не участвует: он публикует инвентарь и готовит уже выделенные устройства.
Жизненный цикл у claim человеческий: создан → планировщик нашёл устройства и записал их в status.allocation → pod стартует на выбранной ноде. Устройства в claim зарезервированы за ним: два пода не получат одну карту случайно, а claim можно смотреть, цитировать в тикетах и чистить стандартными средствами kubectl — это полноценный объект API, а не строка в выводе describe node. Работают и приоритеты: при нехватке устройств под с более высоким PriorityClass вытеснит чужой claim — обычный preemption планировщика. Механизм при этом не NVIDIA-специфичный: сетевые адаптеры, FPGA и лицензии заводятся теми же слайсами и классами — просто у NVIDIA драйвер самый зрелый.
Pod с ResourceClaim: как теперь просить GPU
Вместо resources.limits — отдельный объект и ссылка на него в спеке пода.
# gpu-claim.yaml — просим не «единицу GPU», а «карту с памятью от 16 ГБ»
apiVersion: resource.k8s.io/v1
kind: ResourceClaim
metadata:
  name: gpu-16gb
spec:
  devices:
    requests:
      - name: gpu
        exactly:
          deviceClassName: gpu.nvidia.com
          allocationMode: Count
          count: 1
          selectors:                        # вместо счётчика — атрибуты
            - cel:
                expression: "device.attributes['gpu.nvidia.com'].memory >= 16000"
# gpu-pod.yaml
apiVersion: v1
kind: Pod
metadata:
name: vectoradd
spec:
runtimeClassName: nvidia
containers:
- name: cuda
image: nvcr.io/nvidia/k8s/cuda-sample:vectoradd-cuda12.5.1
command: ["./vectorAdd"]
resourceClaims: # ← то, что заменило nvidia.com/gpu
- name: gpu
source:
resourceClaimName: gpu-16gb
resources:
claims:
- name: gpu # устройство доступно контейнерамCEL-селектор комбинирует условия: модель (productName), память, версию драйвера. Для Job и других многоподовых нагрузок claim удобнее не создавать руками, а генерировать шаблоном — каждый под получит собственный:
# claim-template.yaml — под-специфичный claim из шаблона
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  name: gpu-16gb-tpl
spec:
  spec:
    devices:
      requests:
        - name: gpu
          exactly:
            deviceClassName: gpu.nvidia.com
            allocationMode: Count
            count: 1
            selectors:
              - cel:
                  expression: "device.attributes['gpu.nvidia.com'].memory >= 16000"
В поде вместо resourceClaimName — resourceClaimTemplateName: gpu-16gb-tpl: контроллер создаст claim с уникальным именем и удалит его вместе с подом. Отдельный shared-claim (как в примере выше) подходит, когда один выделенный GPU честно делят несколько подов.
Что нужно, чтобы перевести кластер на DRA
Нужны Kubernetes ≥ 1.34, NVIDIA GPU Operator и DRA-драйвер. Перед стартом проверьте три вещи: версию control plane (kubectl version), что container runtime — containerd или CRI-O (DRA-механика доставки устройств опирается на CDI), и что у вас нет софта, который безусловно требует nvidia.com/gpu в лимитах пода — старые версии Kubeflow и платформенные контроллеры иногда валидируют именно его. На managed-кластерах убедитесь, что control plane уже обновлён: апгрейд может идти по расписанию провайдера. Порядок такой.
1. GPU Operator без device plugin — драйвер GPU, toolkit и DCGM-exporter ставятся как обычно, а плагин выключаем:
helm upgrade --install gpu-operator nvidia/gpu-operator \
  --namespace gpu-operator --create-namespace \
  --set driver.enabled=true \
  --set devicePlugin.enabled=false
2. DRA-драйвер NVIDIA — публикует ResourceSlice и DeviceClass, генерирует CDI-спеки:
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia --force-update
helm upgrade --install nvidia-dra-driver nvidia/k8s-dra-driver \
  --namespace nvidia-dra-driver --create-namespace \
  --set runtimeClassName=nvidia
Свежие релизы GPU Operator умеют ставить DRA-драйвер тем же чартом — если ваша версия так умеет, второй шаг не нужен.
3. CDI в container runtime. Устройства попадают в контейнер через CDI: драйвер пишет спеку с точным списком (nvidia.com/gpu=2), containerd/CRI-O монтируют в контейнер ровно это. Нужен containerd ≥ 1.7 с enable_cdi = true (в containerd 2.0 включено по умолчанию). Быстрая проверка, что runtime готов: crictl info | grep -i cdi.
Drain нод не нужен: существующие поды с nvidia.com/gpu продолжают работать по старому пути, пока вы их не переехали, — API device plugin никто не удалял.
DRA против device plugins
| Device plugin | DRA | |
|---|---|---|
| Что просит под | nvidia.com/gpu: 1 — число | ResourceClaim с атрибутами |
| Кто выбирает устройство | агент на ноде, «какое попало» | kube-scheduler по инвентарю |
| MIG | пере-публикация и гонки | слайсы — устройства с атрибутами |
| Sharing | невидимый оверсабскрипшн | честные доли у планировщика |
| Квоты и мониторинг | extended resource в kubelet | ResourceSlice/claim в API кластера |
| Требования к кластеру | любая версия Kubernetes | ≥ 1.34, containerd/CRI-O с CDI |
| Статус | maintenance mode у NVIDIA | GA в 1.34, гейт locked в 1.35+ |
Что ломается при миграции
Сам переезд мягкий — старые поды живут, — но обвязка вокруг счётчиков переезжать отказывается.
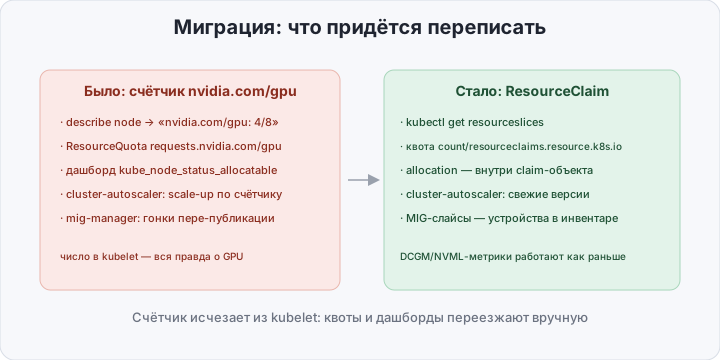
- квоты — ResourceQuota с
requests.nvidia.com/gpuперестаёт срабатывать: claim не входит в requests пода. Рабочий вариант сегодня — счётчик объектов на namespace. Грубее (устройства очень разные), но расход лимитирует:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: gpu-claims
spec:
  hard:
count/resourceclaims.resource.k8s.io: "4"- дашборды —
kubectl describe nodeбольше не показываетnvidia.com/gpu: 4/8, метрикаkube_node_status_allocatable{resource="nvidia_com_gpu"}уходит в ноль. DCGM-exporter работает как раньше: он читает карты через NVML и о способе выделения не знает —DCGM_FI_DEV_GPU_UTILи метрики памяти живы; - autoscaling — проверьте свою связку до переезда: свежие cluster-autoscaler видят Pending-поды с claims и досыпают ноды, старые версии и часть проприетарных скейлеров claims не замечают — под висит вечно. Kueue уже считает claims в своих квотах;
- привычки в CLI — «сколько GPU свободно» теперь
kubectl get resourceslices, а неdescribe node.
Когда DRA реально даёт выигрыш
Если все карты одинаковые и один под занимает карту целиком, DRA ничего революционного не даст — только соответствие стандарту. Выигрыш появляется на неоднородном железе:
- MIG — слайс запрашивается по профилю («1g.10gb на A100»), репартиционирование для планировщика — просто смена инвентаря, без гонок между mig-manager и счётчиком;
- sharing — time-slicing выглядит как несколько устройств одного GPU: каждая доля зарезервирована, два пода на карте — решение планировщика, а не молчаливый оверсабскрипшн;
- атрибуты — «память ≥ 70 ГБ под модель», «H100 для инференса»: тяжёлые задачи перестают падать CUDA OOM на маленькой карте при свободной большой. Инференс-и-обучение на одном кластере больше не договариваются словами «просто возьми любую свободную»: селектор
productName.startsWith('NVIDIA H100')в одном claim иmemory >= 70000в другом — и планировщик разводит их сам; - capacity у устройств — не только дискретные единицы: сетевые адаптеры и лицензии режутся тем же механизмом.
Как проверить, что всё работает
После установки драйвера:
kubectl get resourceslices                      # инвентарь опубликован
kubectl describe deviceclass gpu.nvidia.com     # какие атрибуты можно селектить
kubectl apply -f gpu-claim.yaml
kubectl get resourceclaim gpu-16gb              # allocation: конкретная карта
kubectl get pod vectoradd -w                    # Pending → Running
kubectl exec vectoradd -- nvidia-smi -L         # под видит ровно выданное
kubectl describe resourceclaim gpu-16gb         # атрибуты и выделенное устройство
Если под висит в Pending — kubectl describe pod: в events будет причина, например «no devices match selector» — селектор строже инвентаря. А если kubectl get resourceslices пуст — смотрите логи подов nvidia-dra-driver: без драйвера инвентарь не появится.
Итог
Device plugins для GPU — легаси: NVIDIA развивает только DRA-драйвер, а в 1.35+ фича-гейт закреплён навсегда. Плата за переезд — переписать пару квот и дашбордов; выигрыш — планировщик, который видит MIG, шаринг и объём памяти, вместо лотереи «первый попавшийся». Мигрировать лучше сейчас, пока оба пути работают параллельно: поднимите DRA-драйвер рядом с плагином, переведите некритичные Job-ы, перепишите квоты и дашборды — и только потом выключайте device plugin, namespace за namespace. А если у вас на кластере уже живёт observability-стек — audit-логи Kubernetes в Wazuh мы разбирали отдельно.