

Понедельник, 07:00. Кластер не поднимается после отказа ноды, вы открываете список бэкапов — и понимаете, что ни один из них ни разу не восстанавливали. Зелёный список бэкапов — это не план восстановления, это перечень того, что вы не пробовали поднять. Velero закрывает обе половины уравнения: бэкап кластера в S3 по расписанию и дешёвый способ прогнать восстановление в чистом namespace — хоть каждый месяц.
Почему сейчас: Velero 1.18 — актуальная линейка 2026 года, AWS обновила официальные гайды для EKS (май 2026), появились свежие практические разборы настройки на S3. Ниже — минимальный контур, который стоит собрать: ежедневные бэкапы с TTL, CSI-снапшоты и репетиция restore с алертом.
Содержание
Открыть содержание
Что значит «забэкапить кластер»
В кластере три слоя, и бэкапить их нужно по-разному:
- Объекты кластера — Deployment, Service, ConfigMap, Custom Resources. Это YAML, который живёт в etcd.
- Данные томов — содержимое PersistentVolumeClaim: файлы, загрузки, встроенные SQLite-базы.
- Состояние баз — WAL Postgres, транзакции в полёте. Отдельная вселенная со своими инструментами.
Классические подходы закрывают слои по отдельности — и не закрывают главный вопрос: поднимется ли всё это вместе на новом месте.
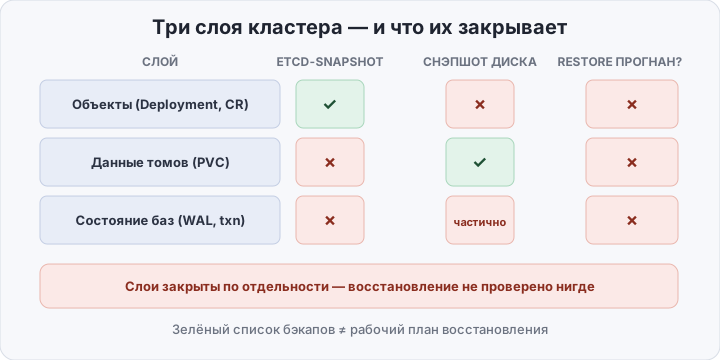
Пройдёмся по привычным инструментам:
etcdctl snapshot save— честный бэкап объектов, но только объектов: на данные томов он не смотрит. Восстановление — это восстановление всего кластера целиком, на остановленном control plane.- Снапшоты дисков у провайдера — данные томов есть, объектов нет: вы вернёте файлы в мир, где больше нет ни Deployment, ни Service.
kubectl get -o yamlпо cron — конспект объектов без данных томов, без истории и без гарантий, что это вообще применимо.- Restic на хостах — замечательно для файлов вне кластера, но про PVC и порядок запуска подов он ничего не знает.
Каждый инструмент по-своему прав. Проблема не в них, а в том, что «бэкап кластера» — это три задачи, решённые согласованно, плюс одна, которую никто не любит: проверка, что из этого поднимается. Согласованно — ключевое слово: слои, снятые в разное время и разными инструментами, при восстановлении собираются в кластер, которого никогда не существовало. Часть подов ссылается на секреты из вчерашнего снапшота, часть — на томы из позавчерашнего, и поиск «какой кусок от какого времени» съедает ночь.
Что меняет Velero
Velero — контроллер, который превращает бэкап и восстановление в обычные Custom Resources кластера. Конкретно это даёт:
- Объекты и данные томов — одним механизмом. Манифесты выбранных namespace уезжают в tar, данные PVC — одним из двух способов на выбор.
- CSI VolumeSnapshot — снапшот силами storage-класса: быстро и атомарно, но копия живёт в той же storage-системе, что и прод.
- node-agent (Kopia) — DaemonSet, который читает том на уровне файлов и пишет копию в S3. Копия живёт вне кластера и переживает потерю СХ целиком.
- Schedule с TTL — ротация бэкапов без внешнего cron и скриптов очистки: просроченные удаляет сам контроллер.
- Restore — это тоже CR. CLI только постит ресурс; работу делает сервер. Restore умеет переименовывать namespace’ы и подменять конфиги на лету.
- Гранулярность. Бэкапить можно весь кластер, один namespace или объекты по label-selector — ReplicaSet руками вычищать не придётся.
- Наблюдаемость. Бэкапы и restore видны через
kubectl get backups.velero.io, у каждого фаза (InProgress→Completed/Failed) и свой лог. Бэкап перестаёт быть чёрным ящиком скрипта на ноде.
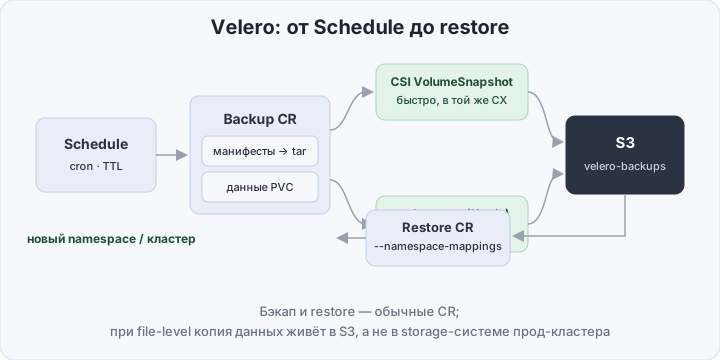
Ключевой сдвиг не «ещё один бэкапщик», а то, что restore стал операцией уровня кластера, которую можно запускать скриптом — а значит, и по расписанию.
| etcd-snapshot + скрипты | Velero | |
|---|---|---|
| Объекты кластера | да, но всем кластером сразу | да, выборочно по namespace |
| Данные PVC | нет | да: CSI-снапшот или Kopia в S3 |
| Расписание и TTL | свой cron и свои скрипты очистки | Schedule CR, TTL из коробки |
| Restore в другой namespace | нет | --namespace-mappings |
| Независимость от storage-кластера | неприменимо | file-level копия лежит в S3 |
| Проверка restore | ручная, «когда-нибудь» | restore — CR, гоняется Job’ой по расписанию |
| Что крутится в кластере | cron-скрипты на нодах | Deployment + DaemonSet |
Что нужно, чтобы поднять бэкапы на Velero
Минимальный путь из четырёх шагов — от пустого кластера до первого восстановленного namespace.
1. Бакет и credentials. Отдельный бакет в S3 или MinIO и отдельный ключ с правами только на него:
[default]
aws_access_key_id=AKIA...
aws_secret_access_key=...
2. Установка. Один вызов CLI разворачивает всё: контроллер, location’ы и — при --use-node-agent — DaemonSet для file-level бэкапов:
velero install \
  --provider aws \
  --plugins velero/velero-plugin-for-aws:v1.14.0 \
  --bucket velero-backups \
  --backup-location-config region=ru-central1,s3Url=https://s3.example.internal,s3ForcePathStyle=true \
  --snapshot-location-config region=ru-central1 \
  --use-node-agent \
  --features=EnableCSI \
  --secret-file ./credentials-velero
Тонкости: для MinIO обязательны s3Url и s3ForcePathStyle=true; версию плагина сверьте с вашей версией Velero — совместимость ломается между мажорами; флаг --features=EnableCSI требует VolumeSnapshot CRDs и запущенного snapshot-controller в кластере.
3. Schedule. Расписание живёт в кластере как CR — ежедневный бэкап в 03:00 с TTL неделя:
apiVersion: velero.io/v1
kind: Schedule
metadata:
  name: daily
  namespace: velero
spec:
  schedule: "0 3 * * *"
  ttl: 168h0m0s
  template:
    includedNamespaces: ["app", "infra"]
    defaultVolumesToFsBackup: true
    snapshotVolumes: false
defaultVolumesToFsBackup: true — главный флаг: каждый PVC без явных исключений уезжает в S3 через node-agent. snapshotVolumes: false здесь осознанно: для малого кластера дешевле одна консистентная схема, чем две. TTL 168h0m0s — ровно 7 суток, дальше контроллер удаляет сам.
Сколько хранить — считайте от худшего сценария: вы замечаете тихую поломку (протухший токен, уехавший конфиг) не сразу. Семи дневных копий хватает, когда проблему видно за день-два; если нет — добавьте второй Schedule weekly с TTL 720h (месяц) и schedule: "0 4 * * 0". Это защита от «неделю бэкапим уже сломанное» ценой четырёх дополнительных копий в бакете. И учтите: по умолчанию Velero тянет объекты только из указанных namespace — cluster-scoped ресурсы (CRD, ClusterRole) попадают в бэкап с флагом --include-cluster-resources, при restore они воссоздаются вместе с namespace’ами.
4. Первый restore — руками, немедленно. Пока бэкапов один-два, прогоните восстановление лично:
velero restore create restore-test \
  --from-backup daily-2026-11-03 \
  --namespace-mappings app:app-test
velero restore describe restore-test --details
Restore создаст объекты из бэкапа в namespace app-test, а данные PVC вернёт в новые тома — убедитесь, что в кластере есть storage-class, который умеет их динамически биндить. --namespace-mappings — тот самый мост «прод → стенд»: ни прод, ни его namespace не трогаются.
Репетиция восстановления по расписанию
Один ручной restore доказывает, что бэкап рабочий — сегодня. Через полгода конфиги, версии и storage-class уедут, и доказательство устареет. Значит, прогон должен повторяться сам, а результат — куда-то репортиться.
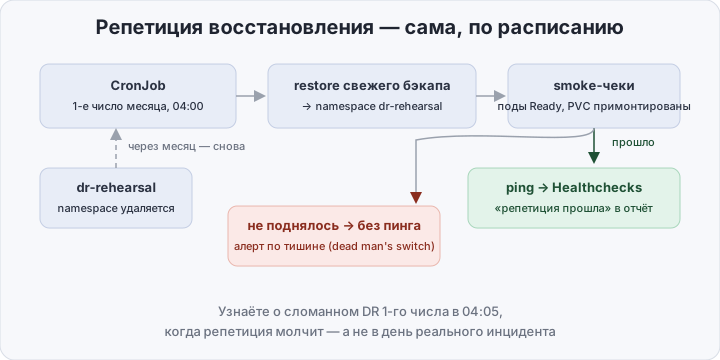
Раз в месяц CronJob берёт свежий бэкап, восстанавливает его в scratch-namespace и делает smoke-чеки:
set -eu
B=$(velero backup get -o name | tail -1)
NS=dr-rehearsal
velero restore create "rehearsal-$(date +%F)" \
  --from-backup "${B##*/}" \
  --namespace-mappings "app:${NS}"

until [ "$(velero restore get "rehearsal-$(date +%F)" -o jsonpath='{.status.phase}')" = "Completed" ]; do
  sleep 20
done

kubectl -n "$NS" wait --for=condition=Ready pod --all --timeout=300s
curl -fsS "https://hc-ping.com/<uuid>"   # сигнал: репетиция прошла
kubectl delete ns "$NS"                  # уборка за собой
Если что-то упало — скрипт не доходит до curl, пинга нет, и Healthchecks.io шлёт алерт по тишине. Это dead man’s switch — тот же приём, что для файловых бэкапов в статье про restic и Healthchecks: мониторить надо не наличие бэкапов, а факт успешного восстановления.
Job’е нужен свой ServiceAccount с узкими правами: get/list на backups, create/get на restores, create/delete на namespaces, list на pods. Ничего больше.
Три практических замечания. Первая репетиция — только руками: автопрогон имеет смысл, когда вы хотя бы раз видели, как выглядит успешный restore, — иначе дебажите сразу и Job’у, и бэкапу. Smoke-чеки — по глубине инцидента: kubectl wait на Ready достаточно для MVP; следующим шагом добавьте HTTP-пробу на реальный endpoint приложения — под может быть Ready, а приложение внутри — нет. Уборка обязательна: namespace dr-rehearsal удаляется в конце даже при падении скрипта (trap), иначе PVC и поды копятся, а следующая репетиция восстанавливается поверх мусора.
Границы: Postgres бэкапится сам
Снапшот тома с живой Postgres — это «почти»: часть WAL в кэше страниц, снапшот может снять диск между чекпоинтами. Для файлов и однодисковых приложений file-level бэкап достаточен; для базы — нет.
Поэтому граница проходит так: Postgres бэкапится своими инструментами — pgbackrest, Barman или нативный бэкап оператора CloudNativePG с WAL-архивом в S3. Velero остаётся вокруг базы: манифесты кластера, секреты, ConfigMaps — всё, что нужно, чтобы поднять саму базу на новом месте и накатить на неё бэкап. Crash-consistent restore базы из тома — аварийный запасной выход, а не план.
Если база попроще — single-instance MySQL или SQLite в PVC — конвейер всё равно можно собрать на Velero: у бэкапов есть pre/post-hooks — команды в контейнере до и после копирования тома (FLUSH TABLES WITH READ LOCK перед, unlock после; для файловых хранилищ — fsfreeze). Медленнее и капризнее нативного mysqldump, но целостность снимка перестаёт быть лотереей.
Как проверить, что всё работает
- Бэкап:
velero backup describe daily-2026-11-03 --details— phaseCompleted, в разделе volumes видно, сколько PVC уехало через node-agent и сколько ошибок. - Restore:
velero restore describe <имя> --details— различайтеCompletedиCompletedWithWarnings: второй означает частично пропущенные объекты, и это уже повод разбираться. - Расписание:
kubectl -n velero get schedulesиvelero backup get— свежие бэкапы появляются без вашего участия. - Метрики: деплоймент Velero отдаёт
/metrics—velero_backup_last_successful_timestampи счётчики failed удобны для дашборда и алертов.
Итог
План восстановления, который ни разу не прогонялся, не существует — существует документ с оптимистичными допущениями. Velero делает прогон дешёвым: раз в месяц Job восстанавливает свежий бэкап в чистый namespace, гоняет smoke-чеки и репортит пинг — и вы узнаёте о сломанном DR утром репетиции, а не утром инцидента. Плата: контроллер с DaemonSet в кластере, бакет в S3 и честное отношение к базам через их собственные механизмы бэкапа. Для кластера, который стоит меньше недели работы, это самая дешёвая страховка на рынке Day-2.